
El procesamiento inteligente de documentos (IDP) usa IA y tecnologías relacionadas para convertir el contenido de los documentos en información que un flujo de trabajo puede utilizar. Un sistema típico clasifica los documentos entrantes, extrae los datos relevantes, valida los resultados y pasa la información revisada al siguiente paso. La prueba real es si el resultado es lo suficientemente fiable para la acción que sigue, no si el sistema puede leer una página.
La explicación de AWS sobre el IDP describe estas etapas, incluidos controles contra reglas de negocio o datos existentes. Ese paso de validación importa: un importe de factura plausible aún puede estar equivocado, y un valor extraído correctamente puede pertenecer a una factura que tu sistema ya ha recibido.
Empieza con la acción después de la extracción
Antes de evaluar una herramienta, termina esta frase: “Una vez que el documento haya sido procesado, necesitamos…” La respuesta podría ser crear un registro, asignar un revisor, comparar la información con una orden de compra o preparar un informe. Cada resultado necesita controles diferentes y un nivel distinto de automatización.
Si la tarea termina con una persona que lee un resumen, la comprensión del documento puede ser suficiente. Si la salida cambia un registro en otro sistema, también necesitas un esquema definido, reglas de validación y una vía para excepciones. Estos requisitos deben establecerse antes del piloto, porque una demostración de extracción por sí sola no puede demostrar que todo el flujo de trabajo está listo.
Las etapas de un flujo de trabajo de IDP
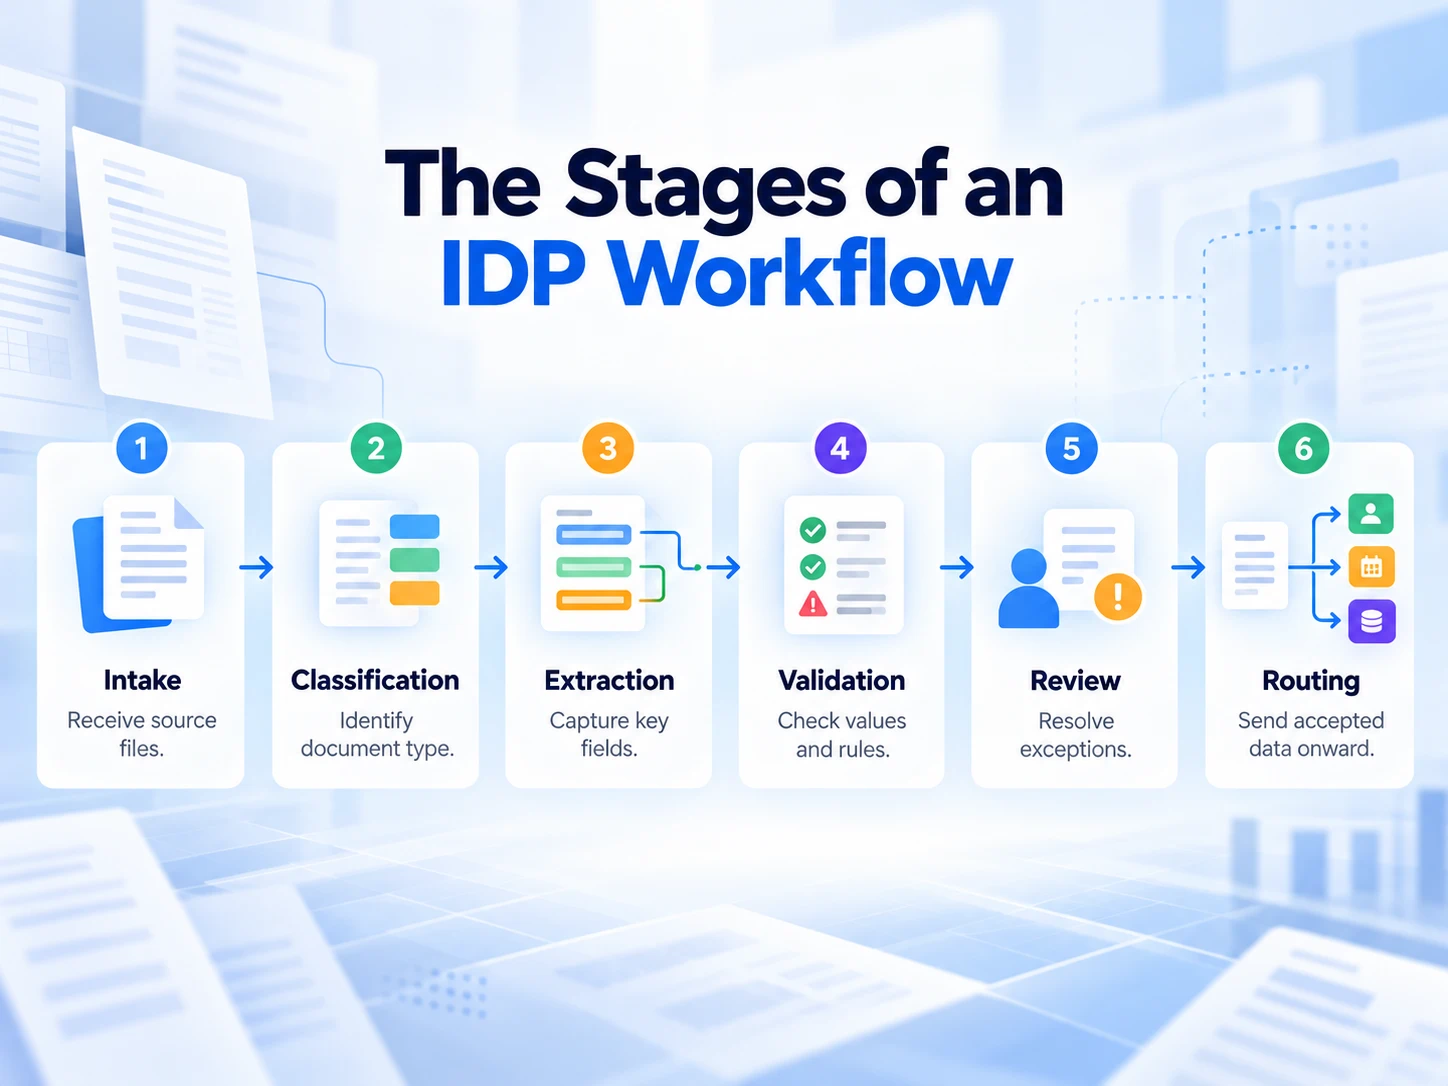
| Etapa | Propósito | Ejemplo de fallo que no detectar |
|---|---|---|
| Admisión | Recibir e identificar los archivos de origen | El mismo archivo llega dos veces |
| Clasificación | Determinar el tipo de documento o la categoría relevante | Una nota de crédito se trata como una factura |
| Extracción | Capturar los campos necesarios para la tarea | Un subtotal se captura como el total |
| Validación | Comprobar valores, relaciones e información requerida | El total no cumple la regla de cálculo acordada |
| Revisión | Resolver resultados ambiguos o rechazados | Una fecha poco clara recibe una suposición injustificada |
| Enrutamiento | Pasar la información aceptada al siguiente paso | Un registro válido se envía al destino equivocado |
Este es un modelo de planificación, más que una garantía de que cada producto de IDP incluya las seis etapas. Revisa qué componentes ofrece un servicio y cuáles debes construir o configurar tú.
La clasificación determina la interpretación siguiente
Los documentos pueden parecer similares mientras cumplen propósitos distintos. Una factura, una orden de compra y una nota de crédito pueden contener nombres, fechas e importes, pero no deberían activar la misma acción. La clasificación determina qué reglas de extracción y requisitos de revisión se aplican.
La visión general de Microsoft sobre Document Intelligence describe clasificadores personalizados junto con modelos de extracción. Su distinción muestra por qué reconocer el tipo de documento y extraer su contenido son trabajos separados. Un flujo de trabajo también debería definir qué ocurre cuando el tipo es incierto o queda fuera del conjunto esperado.
La extracción requiere una definición clara de cada campo
“Extraer la fecha” es ambiguo cuando un archivo contiene una fecha de emisión, una fecha de servicio y un plazo de pago. Define el campo que necesitas y cómo debería aparecer en la salida. Incluye reglas para valores faltantes y conserva la información necesaria para comprobar la extracción.
Por ejemplo, un esquema de factura podría solicitar el nombre del proveedor, el número de factura, la fecha de la factura, la moneda, el total y el impuesto. Esas definiciones de campos deben indicar qué valor elegir cuando un documento presenta varios candidatos. Agregar un campo es fácil; decidir qué cuenta como resultado correcto requiere más cuidado.
La validación comprueba más que la legibilidad
Algunas comprobaciones confirman que un valor tiene la forma esperada. Otras comprueban relaciones dentro del documento o comparan los datos extraídos con un registro de confianza. Una fecha puede estar correctamente formateada y, aun así, representar el evento equivocado, y un total puede ser legible pero no ser coherente con las partidas.
Define la regla de negocio y la acción cuando falle. Por ejemplo, la falta del número de factura puede requerir revisión, mientras que una combinación repetida de proveedor y número de factura puede activar una comprobación de duplicados. Pasar una comprobación de formato no debería autorizar automáticamente una acción posterior.
Un ejemplo de factura resuelto
Imagina una factura de un proveedor con estos detalles: la fecha de emisión es 5 de marzo, la fecha de vencimiento es 4 de abril, el subtotal es 1,000 y el total es 1,080. La moneda no está impresa con la claridad suficiente para determinarla. Este es un ejemplo ilustrativo, no un resultado medido de una prueba de producto.
Un sistema de extracción podría devolver un registro con buen aspecto, con el 4 de abril como fecha de factura, 1,000 como total y una moneda estimada. Cada valor es plausible por separado. Juntos, muestran por qué un flujo de trabajo de IDP necesita significados explícitos de los campos y reglas de revisión.
| Campo solicitado | Valor revisado | Comprobación de aceptación |
|---|---|---|
| Fecha de la factura | 5 de marzo | Usar la fecha de emisión, no la fecha de vencimiento |
| Fecha de vencimiento | 4 de abril | Mantenerla separada de la fecha de la factura |
| Total | 1,080 | Identificar el total final e inspeccionar sus componentes |
| Moneda | Sin resolver | Dejarla sin resolver y solicitar revisión |
El siguiente paso correcto es resolver la moneda antes de usar el registro donde la moneda importe. Un registro con apariencia completa creado por suposición es menos útil que un registro incompleto que identifique claramente qué debe comprobar un revisor.
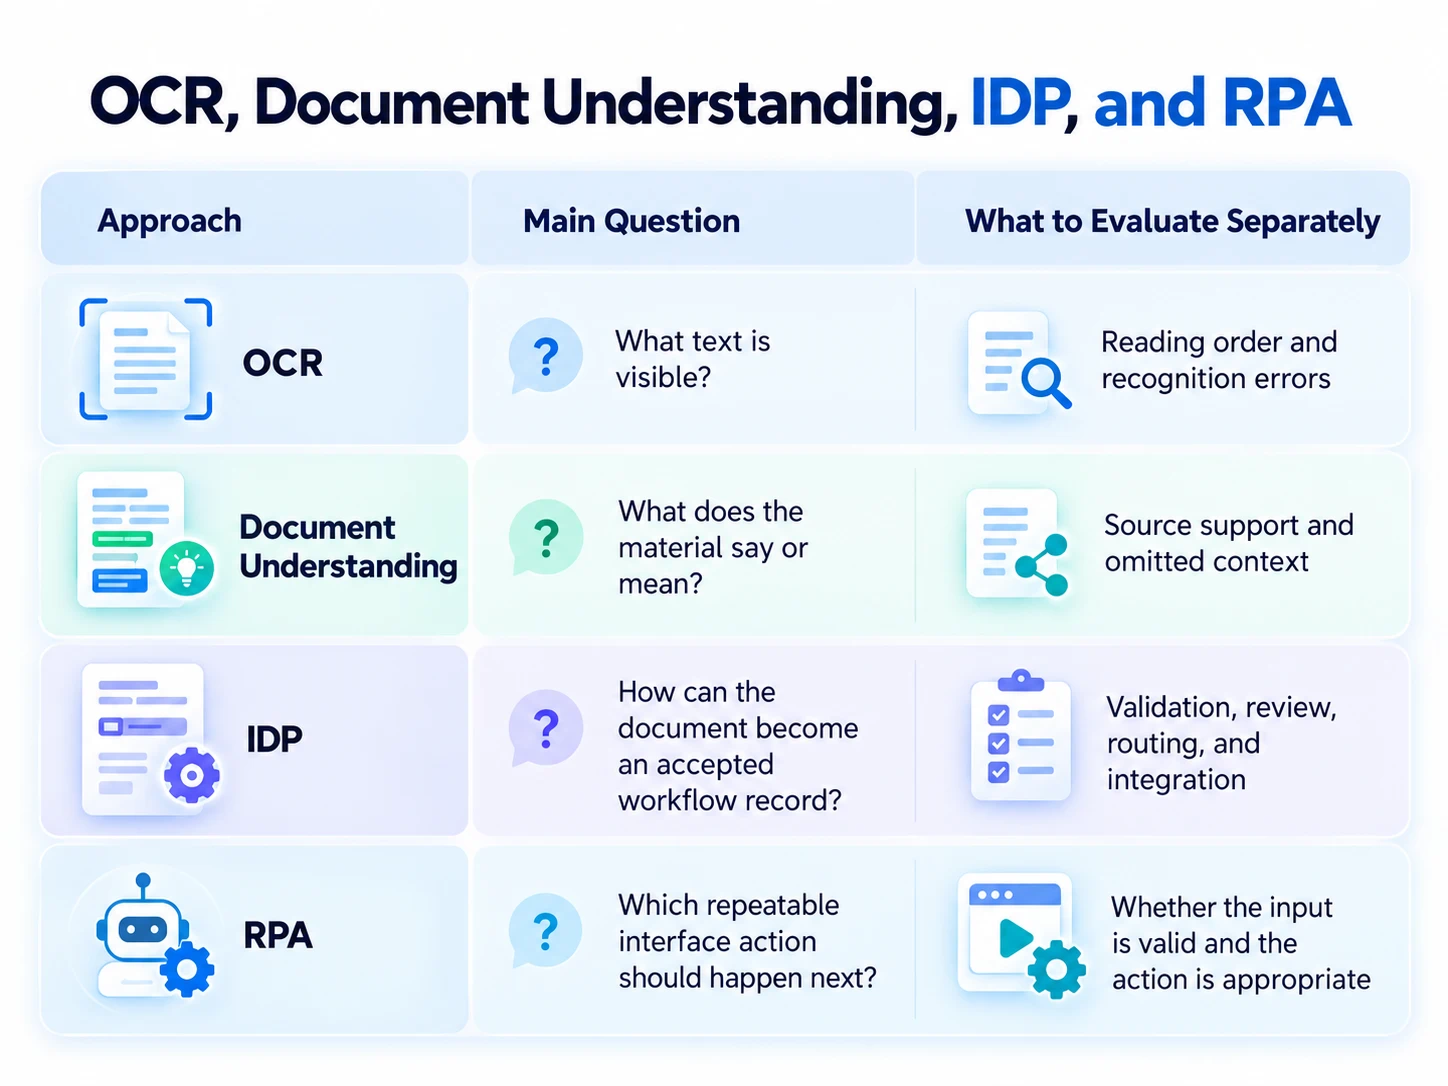
OCR, Document AI, IDP y RPA
El Document AI de Google ofrece procesadores para OCR, extracción y clasificación. Estos componentes demuestran cómo un flujo de trabajo puede usar distintas capacidades para diferentes etapas. La existencia de un extractor no te indica si tus reglas de validación o la gestión de excepciones se han implementado.
| Enfoque | Pregunta principal que responde | Qué evaluar por separado |
|---|---|---|
| OCR | ¿Qué texto es visible? | Orden de lectura y errores de reconocimiento |
| Comprensión del documento | ¿Qué dice o significa este material? | Soporte de la fuente y contexto omitido |
| IDP | ¿Cómo puede el documento convertirse en un registro aceptado del flujo de trabajo? | Validación, revisión, enrutamiento e integración |
| RPA | ¿Qué acción repetible de la interfaz debe ocurrir a continuación? | Si la entrada es válida y si la acción es apropiada |
Los límites son prácticos más que absolutos: los productos pueden combinar varios enfoques. Usa esta distinción para formular mejores preguntas de evaluación, en lugar de asumir que una etiqueta de marketing define el sistema completo.
Dónde la IA generativa ayuda y dónde todavía importan las reglas
Los modelos generativos pueden interpretar instrucciones y lenguaje variado, lo que los hace relevantes para una extracción flexible y la comprensión de documentos. Google describe un extractor personalizado basado en IA generativa en su oferta Document AI. Esto respalda la afirmación de capacidad para ese producto; no establece un nivel universal de precisión para cada archivo o flujo de trabajo.
Para un piloto de inteligencia de procesamiento de documentos con IA, define qué se permite que el modelo infiera. Algunas tareas necesitan un valor normalizado; otras requieren una transcripción directa. Mantén esos modos distintos para que los revisores puedan saber si un campo proviene de una afirmación explícita o de una interpretación.
Un prompt puede pedir “usar null cuando falte”, pero el flujo de trabajo aún debe comprobar la salida. No confíes en explicaciones fluidas como evidencia de que un campo es correcto. Revisa el fragmento de fuente relevante, la definición del campo y cualquier regla aplicada después de la extracción.
Cómo diseñar un piloto de IDP útil
Elige una familia de documentos y un resultado
Empieza con una tarea acotada, como extraer campos especificados de facturas de proveedores para revisión. Define qué producirá el piloto y quién inspeccionará las excepciones. Ampliar a varias familias de documentos antes de que se entienda el primer flujo de trabajo puede hacer que los fallos sean más difíciles de diagnosticar.
Construye un conjunto de evaluación representativo
Incluye ejemplos habituales y las variaciones que esperas recibir: campos faltantes, diseños poco familiares, documentos de varias páginas, escaneos deficientes y duplicados. Haz que un revisor establezca los resultados esperados antes de probar. Mantén un conjunto separado reservado para que la evaluación final incluya archivos que no guíen tus decisiones de configuración.
Mide los resultados en el nivel adecuado
La corrección de los campos y la aceptación del documento responden a preguntas distintas. Un sistema puede capturar la mayoría de los campos correctamente mientras que con frecuencia omite el campo necesario para completar la tarea. Registra qué campos fallan, con qué frecuencia los documentos necesitan revisión y qué hace que un registro esté listo para el siguiente paso.
Usa estas definiciones de forma consistente:
- Corrección de campos: campos evaluados correctos divididos entre todos los campos evaluados, usando una regla de coincidencia documentada.
- Tasa de revisión: documentos que requieren revisión humana divididos entre documentos procesados.
- Tasa de aceptación: documentos que cumplen todas las comprobaciones de aceptación definidas divididos entre documentos procesados.
- Esfuerzo de revisión: tiempo dedicado a resolver excepciones, medido con un punto de inicio y uno de finalización consistentes.
Estas son medidas de evaluación sugeridas, no afirmaciones de rendimiento. Separa los campos faltantes de los valores incorrectos y registra también los fallos posteriores, además de los errores de extracción. Esa distinción te ayuda a decidir si debes mejorar el análisis, reescribir la definición de un campo o ajustar la ruta de revisión.
Prueba la gestión de fallos antes de aumentar la automatización
Comprueba qué ocurre cuando un archivo no se puede leer, el tipo de documento es desconocido o los campos requeridos entran en conflicto. El flujo de trabajo debe hacer visible la condición no resuelta y conservar suficiente contexto para un revisor. Verifica que un registro rechazado no pase silenciosamente al siguiente sistema.
Si evalúas una herramienta de “IA de IDP”, pide ver la ruta de excepciones con tus propios documentos representativos. Una demostración exitosa debe incluir cómo se gestiona un fallo, no solo cómo se procesa un archivo habitual.
Dónde encaja iWeaver
Algunas tareas de documentos terminan en comprensión en lugar de en un registro operativo. Si estás leyendo informes o preparando una nota informativa, iWeaver ofrece resúmenes, conversación de IA y organización del conocimiento. Su AI Document Summarizer puede ser un punto de partida para revisar material de origen y decidir qué merece una atención más cercana.
Por ejemplo, pide una visión general de las afirmaciones, la evidencia y las limitaciones de un informe antes de planificar tu análisis. El flujo de trabajo público de documentos de iWeaver admite resúmenes a medida y una exploración de seguimiento. Consulta el documento original siempre que un hecho sea importante y evalúa por separado cualquier capacidad de extracción o integración empresarial requerida.
Preguntas para hacer antes de elegir un sistema de IDP
¿El procesamiento inteligente de documentos es lo mismo que OCR?
OCR se centra en reconocer texto. Un flujo de trabajo de IDP añade trabajos como clasificación, extracción, validación, revisión y enrutamiento. Identifica cuáles de esas etapas necesita realmente tu tarea antes de comparar productos.
¿Puede IDP ejecutarse sin revisión humana?
Depende de los documentos, los criterios de aceptación y las consecuencias del error. Define qué resultados pueden avanzar automáticamente y cuáles requieren revisión. Usa evidencia del piloto para establecer esas reglas en lugar de asumir que la automatización es adecuada para cada entrada.
¿Cómo debería manejar un flujo de trabajo de IDP la información faltante?
Representa el valor faltante explícitamente y aplica una regla definida. Un campo requerido puede causar rechazo o revisión; un campo opcional puede permanecer vacío. Adivinar un valor faltante puede dificultar la auditoría y hacerlo inseguro para usarlo en el siguiente paso.
¿Qué debería probar primero?
Prueba si los campos necesarios para la siguiente acción se capturan correctamente y se validan. Luego prueba excepciones, duplicados y el destino de los registros aceptados. Una puntuación de extracción a alto nivel no es suficiente si el campo crítico o la ruta de fallo siguen siendo poco fiables.
Haz que la primera revisión del flujo de trabajo sea posible
Elige una tarea de documentos concreta, define la salida aceptada y prueba tanto archivos habituales como excepciones. Trata la extracción como una etapa en un proceso cuyo resultado final debe comprobarse. Cuando tu objetivo inmediato sea entender un documento, empieza con un resumen basado en la fuente y úsalo para guiar tu revisión.