
Kimi K3.1 Pro hat niedrigere gelistete Basis-API-Ein- und Ausgaberaten als Claude Opus 5.5. Ob es die bessere Wahl ist, hängt von der Aufgabe ab: Die Anzahl der Versuche, Korrekturen und menschlichen Prüfungen kann wichtiger sein als die Rate pro Token.
Beide Modelle werden für komplexes Coden und Wissensarbeit positioniert. Dieser Vergleich nutzt offizielle Dokumentation und veröffentlichte Ergebnisse der Anbieter, statt eines unabhängigen Hands-on-Tests. Ziel ist es, Ihnen dabei zu helfen, eine sinnvolle Bewertung auszuwählen und dann anhand der Ergebnisse eine Entscheidung zu treffen.
API-Preise: vergleiche die gleiche Art von Nutzung
Zum Startkontext hinter diesem Vergleich siehe die neuen Möglichkeiten von Kimi K3.1 Pro.
Die folgenden US-Dollar-Raten wurden am 24. Oktober 2026 geprüft:
| Pro Million Tokens | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Basis-Eingabe | $2 | $4 |
| Basis-Ausgabe | $10 | $20 |
| Cache-Hit/Lesezugriff | $0.20 | $0.20 |
Das sind API-Raten. Konsumenten-Abonnements, Dienste von Drittanbietern und beschleunigte Modi haben separate Bedingungen.
Betrachten Sie eine hypothetische Anfrage mit 100.000 nicht gecachten Eingabetokens und 10.000 Ausgabetokens. Bei diesen Basisraten würden allein die Eingabe und Ausgabe $0.30 mit K3.1 Pro und $0.60 mit Opus 5.5 kosten. Diese Rechnung schließt Cache-Schreibvorgänge, Tools, Retries und andere Gebühren aus. Sie zeigt den Ratenunterschied; sie ist keine gemessene Aufgabenkostenberechnung.
Für wiederholte Aufgaben erfassen Sie die gesamte Rechnung und die Zeit, die benötigt wird, um ein akzeptiertes Ergebnis zu erreichen. Eine günstigere Anfrage kann zu einem teureren Workflow werden, wenn sie umfangreiche Korrekturen braucht. Eine teurere Anfrage muss ihren Preis durch das rechtfertigen, was sie liefert.
Coding: schauen Sie über eine enge Benchmark-Score hinaus
Der Release-Report von Kimi platziert K3.1 Pro dicht an Opus 5.5 auf Terminal-Bench 4.0. Diese Ergebnisse sind ein Hinweis auf ein bestimmtes Evaluations-Setup, nicht eine Garantie für Ihr Repository.
Für einen hilfreichen Coding-Vergleich wählen Sie eine Aufgabe mit bekanntem Scheitern und einem klaren Akzeptanztest. Geben Sie beiden Modellen denselben Projektzustand, dieselbe Problembeschreibung, Tool-Zugriff und dasselbe Zeitbudget. Behalten Sie getrennte Kopien bei, damit ein Lauf nicht von den Änderungen des anderen profitieren kann.
Prüfen Sie nach jedem Lauf drei Dinge: ob das Problem gelöst ist, ob sich unbeteiligtes Verhalten verändert hat und ob die Erklärung zur tatsächlichen Änderung passt. Dokumentieren Sie jegliche manuelle Intervention. Wenn ein Modell in der Mitte einen Hinweis braucht, gehört diese Intervention in das Ergebnis.
Eine kleine Reparatur der Oberfläche und ein Refactoring-Test über mehrere Dateien prüfen unterschiedliche Fähigkeiten. Nehmen Sie beides nur auf, wenn es auch beide Ihre Workload abbildet. Eine einzelne erfolgreiche Demo ist eine zu schmale Grundlage, um einen gesamten Engineering-Workflow darauf umzustellen.
Dokumentenanalyse: testen Sie, ob Schlussfolgerungen beim Check standhalten
Für Forschungsarbeiten sollte der Vergleich eine Frage enthalten, die sich nicht allein durch das Zusammenfassen eines einzelnen Dokuments beantworten lässt. Verwenden Sie eine Quellensammlung mit einer veralteten Abbildung, einer qualifizierten Behauptung oder einem erkennbaren Widerspruch.
Versuchen Sie denselben Prompt mit beiden Modellen:
Vergleichen Sie die bereitgestellten Berichte. Identifizieren Sie Behauptungen, die übereinstimmen, Behauptungen, die im Konflikt stehen, und Behauptungen, die sich aus dem verfügbaren Belegmaterial nicht miteinander in Einklang bringen lassen. Zitieren Sie die Quelle und die Position für jede Aussage. Trennen Sie berichtete Fakten von Ihrer Interpretation.
Bewerten Sie die Antworten, ohne zuerst auf die Modellbezeichnungen zu schauen. Zählen Sie unbelegte Behauptungen und verpasste Qualifikationen. Prüfen Sie, ob eines der Modelle einen Widerspruch auflöst, indem es eine Erklärung erfindet.
Wenn Sie iWeaver nutzen, um die Quellensammlung vorzubereiten, kann der KI-Dokumentzusammenfasser Ihnen helfen, einen Überblick aufzubauen. Halten Sie die tatsächlichen Vergleichseingaben konsistent; wenn Sie einem Modell eine kuratierte Zusammenfassung geben und dem anderen die Rohdateien, entsteht ein anderes Experiment.
Wann sollten Sie K3.1 Pro zuerst evaluieren?
Nutzen Sie So verwenden Sie Kimi K3.1 Pro, um eine erste Aufgabe einzurichten und das Ergebnis zu prüfen.
Starten Sie mit K3.1 Pro, wenn die niedrigeren gelisteten API-Raten eine echte Kostenbeschränkung abbilden und Sie eine wiederholbare Aufgabe zum Testen haben. Es ist auch ein vernünftiger Kandidat, wenn der neue Release-Fokus auf Coding und Forschung genau die Arbeit trifft, die Sie erledigen müssen.
Kimi K3.1 Pro ist in iWeaver verfügbar, und iWeaver bietet eine kostenlose Testphase des Modells an. Eine begrenzte Dokumentaufgabe ist eine praktische erste Evaluierung: Wählen Sie Quellen, die Sie verstehen, definieren Sie die Ausgabe und prüfen Sie die daraus folgenden Aussagen.
Die Konditionen der Testphase legen nicht die Kosten für die Nutzung von Kims API fest. Bewerten Sie jeden Zugangspfad anhand seiner eigenen Bedingungen.
Wann sollten Sie Opus 5.5 im Vergleich behalten?
Bevor Sie für beschleunigte Ausgaben zahlen, lesen Sie Kimi K3.1 Pro vs. Highspeed, um Geschwindigkeit von der Qualität der Aufgabe zu trennen.
Behalten Sie Opus in der Evaluierung, wenn Sie bereits über einen Workflow verfügen, der gut mit ihm funktioniert. Ein etabliertes Verfahren hat Wert: Prompts, Tools, Review-Gewohnheiten und akzeptierte Outputs brauchen Zeit, um wieder aufgebaut zu werden.
Führen Sie K3.1 Pro gegen eine repräsentative Stichprobe aus, bevor Sie umstellen. Nehmen Sie eine gewöhnliche Aufgabe, eine schwierige Aufgabe und einen Fall auf, den Ihr aktueller Workflow nur schlecht bewältigt. Ein neues Modell ist am nützlichsten, wenn es ein konkretes Problem löst oder die Kosten für ein akzeptiertes Ergebnis senkt.
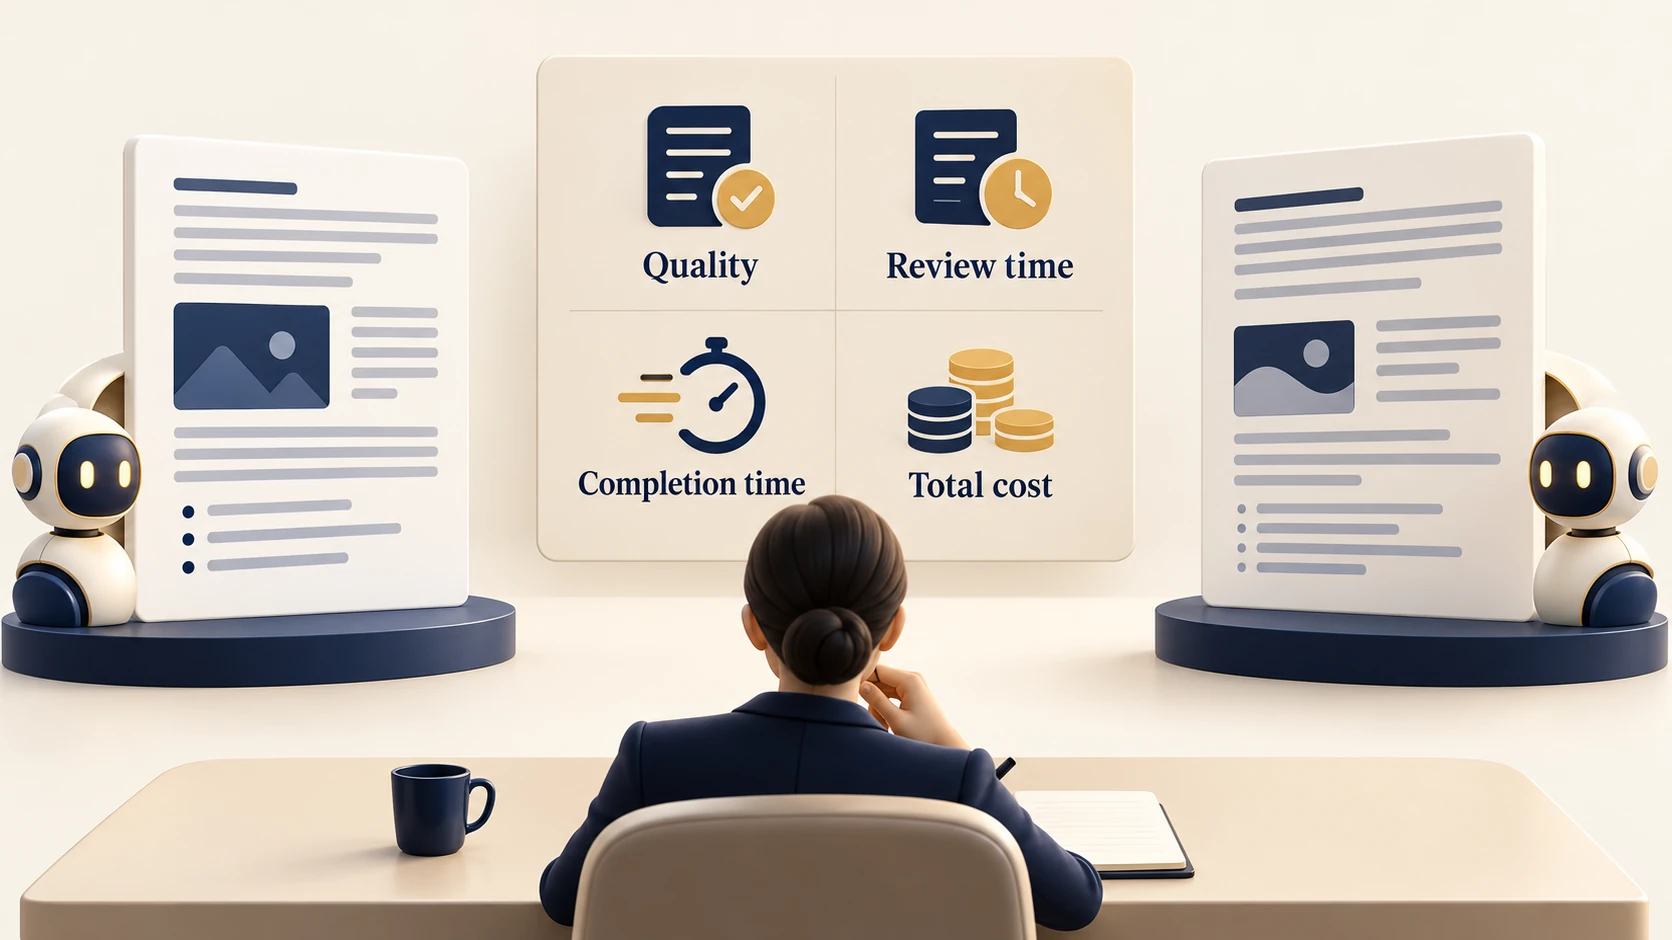
Für eine finale Entscheidung nutzen Sie ein einfaches Scoring-Formular: akzeptierte Ausgabe, Korrekturzeit, Fertigstellungszeit und Gesamtkosten. Wichten Sie diese Faktoren entsprechend dem Job. Ein Forschungsteam priorisiert möglicherweise zuerst die Qualität der Evidenz; ein Batch-Processing-System achtet womöglich stärker auf die Kosten, sobald eine minimale Qualitätsgrenze erreicht ist.
Es ist nicht nötig, ein Modell über jede Aufgabe hinweg zum Gewinner zu erklären. Wählen Sie K3.1 Pro dort, wo es unter Ihren Rahmenbedingungen ein besseres Ergebnis liefert, und behalten Sie Opus dort, wo Ihre Evaluierung unterstützt, es beizubehalten.