
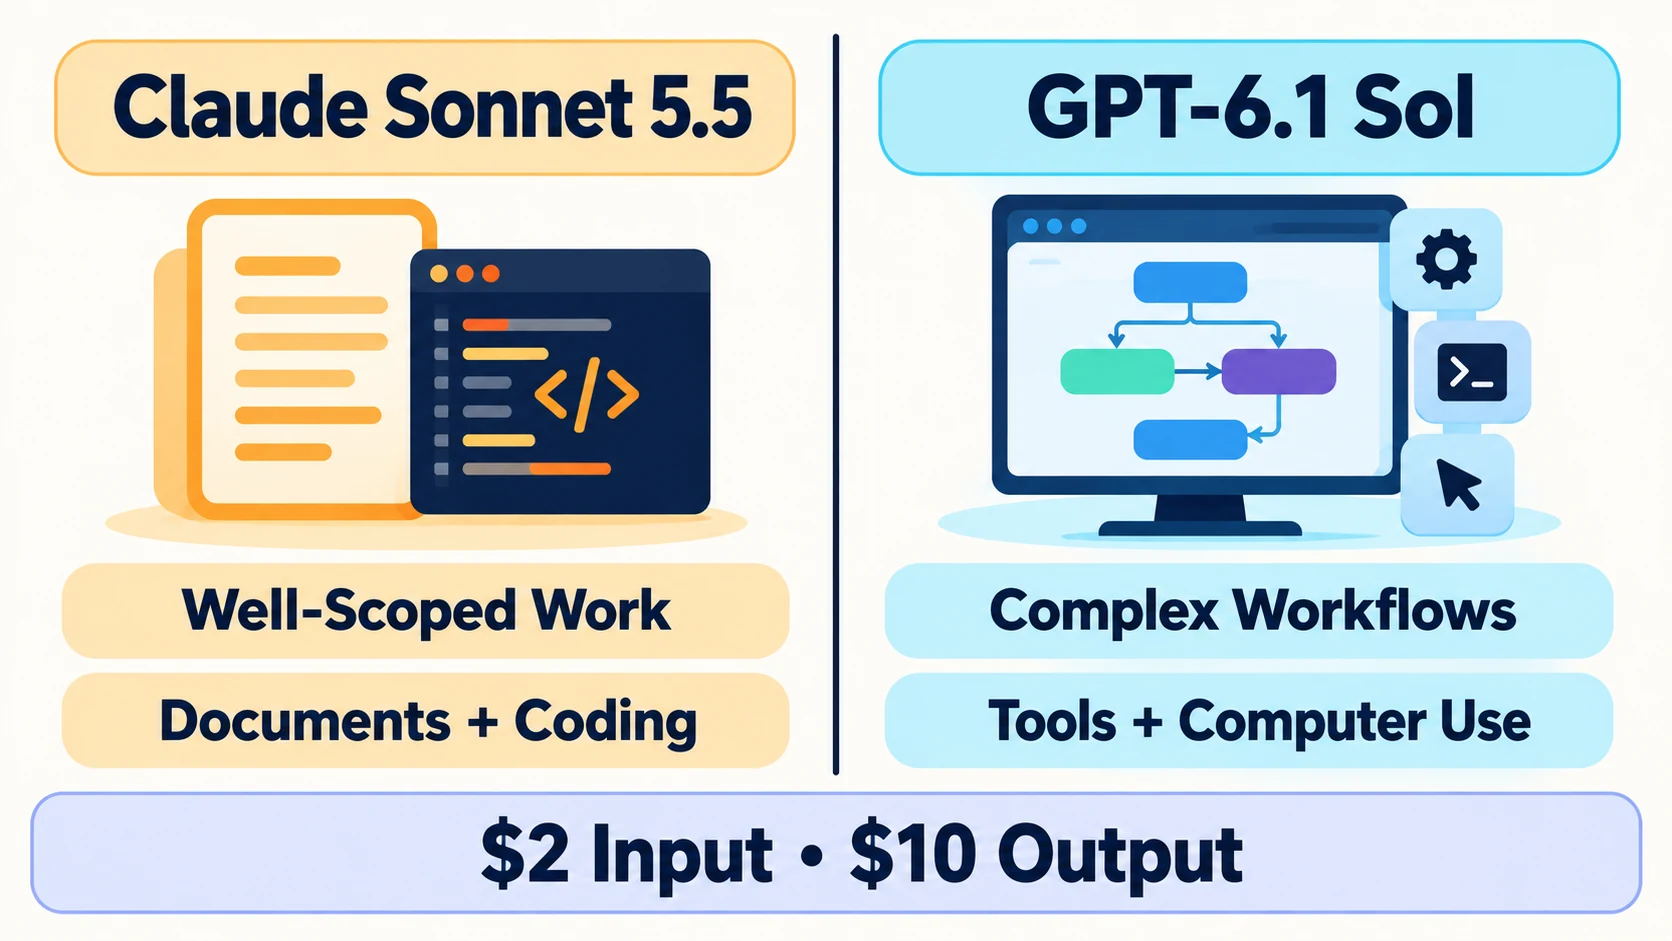
Claude Sonnet 5.5 y GPT-6.1 Sol tienen los mismos precios estándar de tokens de la API, pero están diseñados para aprovechar puntos fuertes distintos. Sonnet 5.5 está orientado a una codificación rápida y bien acotada, y a tareas profesionales. GPT-6.1 Sol se centra en una codificación compleja, el uso del computador, el trabajo guiado por herramientas y flujos de trabajo profesionales, ofreciendo un rendimiento cercano al de Astra a un costo inferior.
La elección práctica depende de la tarea. Sonnet 5.5 merece una prueba para codificación acotada, documentos pulidos, presentaciones y hojas de cálculo. GPT-6.1 Sol es una opción sólida cuando necesitas una ventana de contexto muy amplia, las herramientas de la Responses API de OpenAI o un flujo de trabajo de varios pasos. iWeaver ofrece una prueba gratuita de GPT-6.1 Sol, lo que te permite probar el modelo con tus propios documentos y tareas de investigación antes de decidir.
Claude Sonnet 5.5 vs GPT-6.1 Sol: resumen rápido
| Detalle | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| Precio de entrada estándar | $2 por 1M tokens | $2 por 1M tokens |
| Precio de salida estándar | $10 por 1M tokens | $10 por 1M tokens |
| Precio de lectura de caché | $0.20 por 1M tokens | $0.10 por 1M tokens |
| Ventana de contexto | Revisa la plataforma de Claude seleccionada | 1,050,000 tokens |
| Salida máxima | Revisa la plataforma de Claude seleccionada | 128,000 tokens |
| Enfoque declarado | Codificación bien acotada y tareas profesionales | Codificación compleja, uso del computador y trabajo profesional |
| Control de razonamiento | Esfuerzo ajustable | Bajo, medio, alto, xhigh y max |
| Nombre del modelo de la API | claude-sonnet-5-5 |
gpt-6.1-sol |
Las cifras de GPT-6.1 Sol provienen de la documentación de modelos de OpenAI. Los precios y la posición de Sonnet 5.5 provienen del anuncio de lanzamiento de Anthropic. Los precios de contexto largo, el procesamiento por lotes, los modos rápidos, las escrituras en caché, las llamadas a herramientas y los términos del proveedor en la nube pueden cambiar el costo final.
Codificación: el control del alcance importa tanto como la capacidad bruta
Anthropic presenta Sonnet 5.5 como un modelo rápido para el trabajo profesional cotidiano, corrección de errores y tareas claramente acotadas. En sus materiales de lanzamiento se reportan resultados de codificación sólidos, incluidos 70.6% en Terminal-Bench 4.0 y 46.2% con Max effort en FrontierCode 1.1 Main.
GPT-6.1 Sol está orientado a la codificación compleja y al trabajo de tipo agente. OpenAI también le da acceso a la ejecución de código, shell alojado, apply patch, uso del computador y otras herramientas a través de la Responses API.
Estos hechos no determinan un ganador universal. Una evaluación de codificación debería usar el mismo issue del repositorio, las mismas instrucciones, el mismo entorno y el mismo presupuesto de tiempo. Revisa si el modelo encontró la causa correcta, cambió solo los archivos necesarios, ejecutó comprobaciones adecuadas y se detuvo cuando la tarea estuvo completa.
Elige Sonnet 5.5 para una prueba cuando la tarea está acotada y la iteración rápida importa. Elige GPT-6.1 Sol para una prueba cuando el trabajo requiere un contexto más amplio del repositorio, coordinación de herramientas o varias etapas de implementación y verificación.
Documentos y trabajo de conocimiento
Sonnet 5.5 está orientado explícitamente a crear documentos pulidos, presentaciones y hojas de cálculo. La evidencia del lanzamiento de Anthropic también destaca el trabajo profesional de conocimiento y una eficiencia mejorada frente a Sonnet 5.
GPT-6.1 Sol ofrece una ventana de contexto documentada de 1,050,000 tokens y hasta 128,000 tokens de salida. Eso lo convierte en una opción interesante para grandes conjuntos de documentos, síntesis de investigación, revisión de políticas y entregables estructurados detallados.
La capacidad de contexto por sí sola no prueba la calidad de los documentos. Prueba ambos modelos con el mismo paquete de fuentes y pídeles que extraigan cifras, reconcilien pasajes contradictorios, distingan evidencia de inferencia y muestren de dónde proviene cada conclusión. El modelo que produce un resultado más auditable puede ser más valioso que el que redacta el primer borrador más fluido.
Herramientas y encaje con el flujo de trabajo
La ventaja más clara de GPT-6.1 Sol es su superficie de herramientas documentada a través de la Responses API. Es compatible con búsqueda web, búsqueda de archivos, generación de imágenes, ejecución de código, shell alojado, uso del computador, MCP y búsqueda de herramientas. Esto puede reducir la fricción de integración para los equipos que ya estén construyendo sobre el stack de agentes de OpenAI.
Sonnet 5.5 está disponible a través de productos de Claude, la Claude Platform, AWS, Google Cloud y Microsoft Azure. Puede encajar de forma más natural cuando una organización ya usa esos entornos o tiene prompts y evaluaciones ajustados para Claude.
El ecosistema de la plataforma alrededor del modelo importa. El registro, los permisos, la gestión de fuentes, los pasos de revisión, los requisitos de datos y el flujo de trabajo del equipo pueden superar una pequeña diferencia en un benchmark.
Los lectores que quieran el baseline anterior pueden revisar el Claude Sonnet 5.5 vs GPT-6 comparison publicado por iWeaver antes de evaluar qué cambia con la actualización a la 6.1.
Coste: mismo precio por token, distinto coste según la tarea
Ambos modelos publican precios estándar de $2 por millón de tokens de entrada y $10 por millón de tokens de salida. Eso no significa que cuesten lo mismo completar una tarea.
El costo total de la tarea incluye el tamaño del prompt, el comportamiento de la caché, el esfuerzo de razonamiento, las llamadas a herramientas, los reintentos, la longitud de la salida y la revisión humana. Anthropic afirma que Sonnet 5.5 puede usar menos tokens y ejecutarse más rápido que Sonnet 5, pero esa comparación es con su predecesor, no una prueba de que sea más barato que GPT-6.1 Sol.
Mide el costo total para alcanzar un resultado aceptable. Un modelo que necesita menos correcciones puede salir más barato aunque una respuesta individual sea más larga.
¿Qué modelo deberías elegir?
Prueba Claude Sonnet 5.5 cuando tu prioridad sea una codificación bien acotada, una iteración rápida o documentos pulidos y salidas estilo oficina. Su evidencia pública más sólida y su posicionamiento de producto se alinean con esas tareas.
Prueba GPT-6.1 Sol cuando necesites una ventana de contexto amplia, el ecosistema de herramientas de OpenAI, trabajo complejo de varios pasos o una alternativa de menor costo a Astra. También es la opción más natural cuando tu aplicación ya depende de la Responses API.
Para una decisión justa, ejecuta tres tareas representativas en lugar de un prompt genérico: una tarea rutinaria, una tarea difícil y una tarea con muchas fuentes. Puntuá la corrección, la completitud, la latencia, el total de tokens, los cambios innecesarios y el tiempo de revisión.
Puedes iniciar una prueba gratuita de GPT-6.1 Sol en iWeaver y evaluarlo con tus propios documentos o flujos de trabajo de investigación. El mejor modelo es el que cumple tu estándar de calidad con el menor esfuerzo total, no el que tenga el titular más llamativo.