
GPT-6.1 Sol es el modelo equilibrado de OpenAI para codificación compleja, uso de computadoras y trabajo profesional. OpenAI lo posiciona como una entrega con rendimiento cercano al de Astra a un precio más bajo, convirtiéndolo en la opción intermedia práctica para quienes necesitan más que un modelo ligero, pero no quieren el costo de Astra para cada tarea.
iWeaver ahora ofrece una prueba gratuita de GPT-6.1 Sol, dando a los usuarios una forma directa de probar el modelo en investigación, documentos, escritura, análisis y otras tareas de trabajo con conocimiento antes de decidir cómo encaja en su flujo de trabajo.
GPT-6.1 Sol de un vistazo
| Detalle | GPT-6.1 Sol |
|---|---|
| Mejor para | Codificación compleja, uso de computadora, investigación y trabajo profesional |
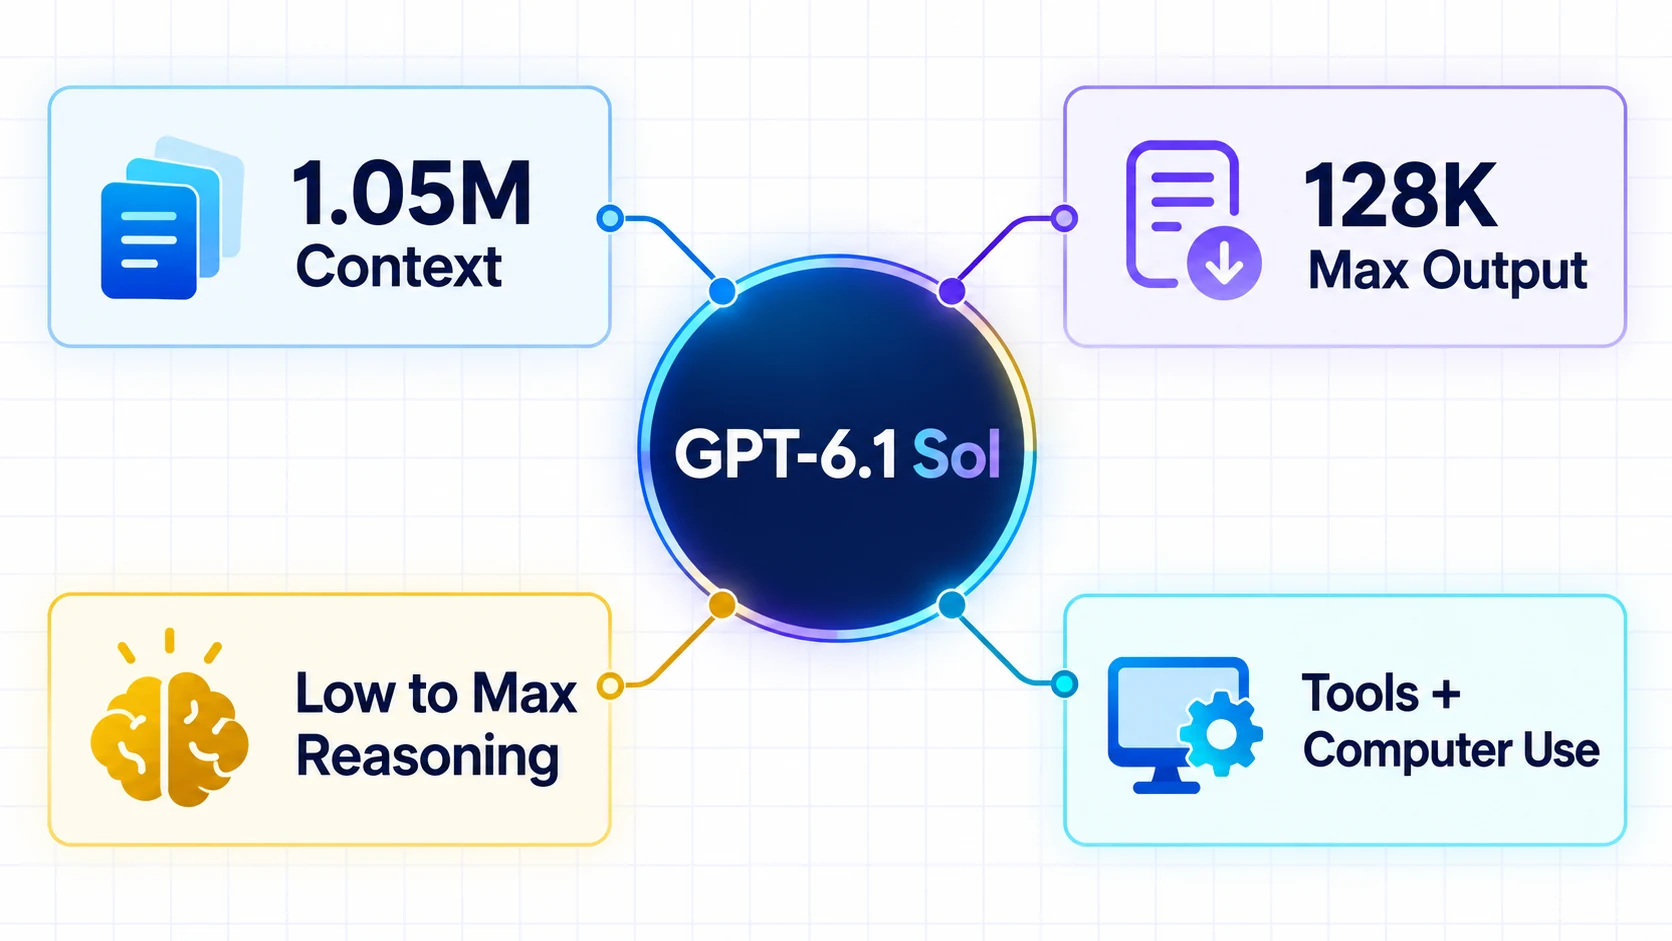
| Ventana de contexto | 1,050,000 tokens |
| Salida máxima | 128,000 tokens |
| Corte de conocimiento | 30 de abril de 2026 |
| Entrada de imágenes | Compatible |
| Entrada de audio y video | No compatible |
| Esfuerzo de razonamiento | Bajo, medio, alto, xhigh y max |
| Precio estándar de entrada de la API | $2 por 1M tokens |
| Precio estándar de salida de la API | $10 por 1M tokens |
| Ajuste fino (fine-tuning) | No compatible |
Estas especificaciones provienen de la página oficial del modelo GPT-6.1 Sol. Los precios de la API pueden cambiar con prompts de contexto largo, modo de procesamiento, almacenamiento en caché, procesamiento regional y llamadas a herramientas; por eso, las tarifas estándar por token son solo un punto de partida para estimar costos.
¿Qué hay de nuevo en GPT-6.1 Sol?
GPT-6.1 Sol ocupa el espacio entre GPT-6 Astra y GPT-6 Luna. Astra está diseñado para el trabajo de extremo a extremo más difícil, mientras que Luna prioriza tareas eficientes y de alto volumen. Sol busca conservar gran parte de la capacidad de Astra a un precio por token sustancialmente más bajo.
Para más contexto sobre el nivel superior, lee la visión general de GPT-6 Astra anterior de iWeaver, que explica el papel que Astra desempeña en el trabajo exigente de extremo a extremo.
El modelo está construido para trabajos que implican varios pasos conectados en lugar de una única respuesta breve. Ejemplos incluyen revisar un conjunto grande de documentos, investigar un problema técnico, coordinar herramientas, producir un informe estructurado o llevar una tarea de codificación desde el diagnóstico hasta la verificación.
“Rendimiento cercano a Astra” es el posicionamiento del producto de OpenAI, no una garantía de que Sol igualará a Astra en cada prompt. La pregunta útil es si Sol cumple los criterios de aceptación para tu tarea, a un costo total menor.
Una ventana de contexto de 1.05M de tokens
GPT-6.1 Sol admite una ventana de contexto de 1,050,000 tokens. Esto deja espacio para grandes bases de código, informes largos, múltiples documentos, transcripciones, documentos de políticas o un historial extendido del proyecto.
Una ventana de contexto amplia no significa que cada detalle cargado reciba automáticamente la misma atención. Los mejores resultados aún dependen de una organización clara de las fuentes y de una solicitud precisa. Para una tarea con un documento grande, dile al modelo:
- Qué archivos son autorizados.
- Qué preguntas debe responder.
- Qué evidencia debe citar o a la que debe hacer referencia.
- Cómo debe estructurarse la salida.
- Qué incertidumbres debe señalar en lugar de adivinar.
iWeaver agrega un flujo de trabajo práctico alrededor de este proceso. Puedes incorporar el material de origen en un solo espacio de trabajo, definir la salida requerida y seguir refinando el resultado en lugar de tratar al modelo como una caja de chat de una sola respuesta.
Esfuerzo de razonamiento: de bajo a max
GPT-6.1 Sol admite cinco niveles de esfuerzo de razonamiento: low, medium, high, xhigh y max. Medium es el valor predeterminado documentado.
Un esfuerzo más bajo puede servir para extracción rutinaria, reescritura, clasificación y preguntas claramente delimitadas. Un esfuerzo más alto es más apropiado cuando una tarea requiere planificación, conciliación de evidencia contradictoria, depuración compleja o un análisis cuidadoso de varios pasos. Más razonamiento no es automáticamente mejor: puede agregar latencia y costo sin mejorar una respuesta sencilla.
El modelo no admite none ni minimal como esfuerzo de razonamiento. Los desarrolladores que migren una aplicación también deben tener en cuenta que la llamada a herramientas pertenece a la Responses API. Chat Completions solo se admite para solicitudes sin herramientas.
¿Qué puede hacer GPT-6.1 Sol?
Analizar documentos e investigación
El modelo puede trabajar a través de colecciones extensas de fuentes, extraer afirmaciones, comparar secciones, identificar contradicciones y producir salidas estructuradas. El resultado aún necesita verificación de fuentes cuando importa la precisión.
Manejar tareas de codificación complejas
GPT-6.1 Sol está diseñado para trabajo de software que requiere contexto del repositorio, uso de herramientas, múltiples ediciones y verificación. Una buena evaluación debe medir la corrección, los cambios innecesarios, los resultados de las pruebas, el tiempo transcurrido y el esfuerzo del revisor, no solo si el modelo produjo código.
Coordinar herramientas
A través de la Responses API, GPT-6.1 Sol admite herramientas que incluyen búsqueda web, búsqueda de archivos, ejecución de código, uso de computadora, generación de imágenes, MCP y búsqueda de herramientas. La disponibilidad y los cargos pueden variar según la herramienta y el entorno.
Crear salidas profesionales
El modelo puede ayudar a convertir material de origen en informes, resúmenes, planes, tablas y borradores estructurados. Su salida máxima amplia admite entregables sustanciales, aunque los prompts concisos y la revisión por etapas suelen ser más confiables que pedir una respuesta final enorme en una sola pasada.
Limitaciones de GPT-6.1 Sol
GPT-6.1 Sol aún puede leer mal una fuente, pasar por alto una excepción, generar código incorrecto o afirmar una inferencia con demasiada confianza. Además, su corte de conocimiento significa que la información actual puede requerir navegación o fuentes proporcionadas y actualizadas.
Para trabajos con consecuencias, verifica citas, cálculos, referencias, ejecución de código y conclusiones del negocio. Trata al modelo como un trabajador capaz dentro de un proceso revisable, no como la autoridad final.
Cómo probar GPT-6.1 Sol
La forma más rápida de evaluar el modelo es usar una tarea cuyo resultado correcto ya comprendas. Elige un informe real, una pregunta de investigación, un conjunto de documentos o un problema de codificación y define qué debe contener una respuesta exitosa.
Puedes probar GPT-6.1 Sol con una prueba gratuita en iWeaver. Agrega tu material de origen, describe el resultado requerido y compara la salida con tu flujo de trabajo habitual. Juzgalo por la precisión, la completitud, el tiempo ahorrado y cuánto necesita revisarse el resultado.
Ese tipo de evaluación a nivel de tarea te dice más que un puntaje de benchmark por sí solo, y también te ayuda a decidir cuándo Sol es suficiente y cuándo conviene usar otro nivel de modelo.