
Kimi K3.1 Pro tiene tasas base de entrada y salida por API listadas más bajas que Claude Opus 5.5. Si es la mejor opción depende de la tarea: la cantidad de intentos, correcciones y revisiones humanas puede importar más que la tarifa por token.
Ambos modelos se están posicionando para programación compleja y trabajo de conocimiento. Esta comparación utiliza documentación oficial y resultados publicados por el proveedor, en lugar de una prueba práctica independiente. El objetivo es ayudarte a elegir una evaluación útil y, luego, tomar una decisión a partir del trabajo que produce.
Precios de la API: compara el mismo tipo de uso
Para el contexto de lanzamiento detrás de esta comparación, consulta Las nuevas capacidades de Kimi K3.1 Pro.
Las siguientes tarifas en dólares estadounidenses se revisaron el 24 de octubre de 2026:
| Por cada millón de tokens | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Entrada base | $2 | $4 |
| Salida base | $10 | $20 |
| Cache hit/lectura | $0.20 | $0.20 |
Estas son tarifas de API. Las suscripciones de consumidores, los servicios de terceros y los modos acelerados tienen condiciones separadas.
Considera una solicitud hipotética con 100,000 tokens de entrada sin caché y 10,000 tokens de salida. Con esas tarifas base, la entrada y la salida costarían $0.30 con K3.1 Pro y $0.60 con Opus 5.5. Este cálculo excluye escrituras de caché, herramientas, reintentos y otros cargos. Ilustra la diferencia de tarifa; no es un costo de tarea medido.
Para tareas repetidas, registra la factura completa y el tiempo necesario para llegar a un resultado aceptado. Una solicitud más barata puede convertirse en un flujo de trabajo más costoso si necesita correcciones extensas. Una solicitud más cara tiene que justificar su precio por el resultado que entrega.
Programación: mira más allá de una puntuación de referencia cercana
El informe de lanzamiento de Kimi sitúa a K3.1 Pro cerca de Opus 5.5 en Terminal-Bench 4.0. Esos resultados son evidencia sobre una configuración de evaluación en particular, más que una garantía sobre tu repositorio.
Para una comparación de programación útil, elige una tarea con un fallo conocido y una prueba de aceptación clara. Dale a cada modelo el mismo estado del proyecto, la descripción del problema, el acceso a herramientas y el presupuesto de tiempo. Mantén copias separadas para que una ejecución no pueda beneficiarse de los cambios de la otra.
Inspecciona tres cosas después de cada ejecución: si el problema se resolvió, si cambió un comportamiento no relacionado y si la explicación coincide con la modificación real. Registra cualquier intervención manual. Si un modelo necesita una pista a mitad de camino, esa intervención debe quedar reflejada en el resultado.
Una reparación pequeña de la interfaz y una prueba de refactorización de varios archivos evalúan capacidades diferentes. Incluye ambas solo si ambas representan tu carga de trabajo. Una demostración exitosa única es demasiado limitada como base para mover un flujo de trabajo de ingeniería completo.
Análisis de documentos: prueba si las conclusiones sobreviven a la verificación
Para trabajos de investigación, la comparación debería incluir una pregunta que no pueda responderse resumiendo un solo documento. Usa una colección de fuentes con una figura desactualizada, una afirmación calificada o una aparente discrepancia.
Prueba el mismo prompt con ambos modelos:
Compara los informes proporcionados. Identifica las afirmaciones que coinciden, las que entran en conflicto y las que no se pueden conciliar con la evidencia disponible. Cita la fuente y la ubicación de cada una. Separa los hechos reportados de tu interpretación.
Revisa las respuestas sin mirar primero las etiquetas del modelo. Cuenta las afirmaciones no respaldadas y las calificaciones omitidas. Verifica si alguno de los modelos resuelve una discrepancia inventando una explicación.
Si usas iWeaver para preparar la colección de fuentes, el AI Document Summarizer puede ayudarte a establecer una visión general. Mantén consistentes las entradas reales de la comparación; dar a un modelo un resumen curado y al otro archivos sin procesar crea un experimento distinto.
¿Cuándo deberías evaluar primero K3.1 Pro?
Usa Cómo usar Kimi K3.1 Pro para configurar una primera tarea y comprobar el resultado.
Empieza con K3.1 Pro cuando las tarifas más bajas listadas de la API aborden una restricción de costo real y tengas una tarea repetible para probar. También es un candidato razonable cuando el nuevo enfoque de la versión en programación e investigación coincide con el trabajo que necesitas hacer.
Kimi K3.1 Pro está disponible en iWeaver, y iWeaver ofrece una prueba gratuita del modelo. Una tarea de documento acotada es una primera evaluación práctica: elige fuentes que entiendas, especifica la salida y revisa las afirmaciones consecuentes.
Los términos de la prueba no establecen el costo de usar la API de Kimi. Evalúa cada vía de acceso por sus propios términos.
¿Cuándo deberías mantener Opus 5.5 en la comparación?
Antes de pagar por una salida acelerada, revisa Kimi K3.1 Pro vs. Highspeed para separar la velocidad de la calidad de la tarea.
Mantén Opus en la evaluación cuando ya tengas un flujo de trabajo que funciona bien con él. Un proceso establecido tiene valor: prompts, herramientas, hábitos de revisión y salidas aceptadas requieren tiempo para reconstruirse.
Ejecuta K3.1 Pro frente a una muestra representativa antes de cambiar. Incluye una tarea ordinaria, una tarea difícil y un caso con el que tu flujo de trabajo actual maneje mal. Un modelo nuevo es más útil cuando resuelve un problema concreto o reduce el costo de un resultado aceptado.
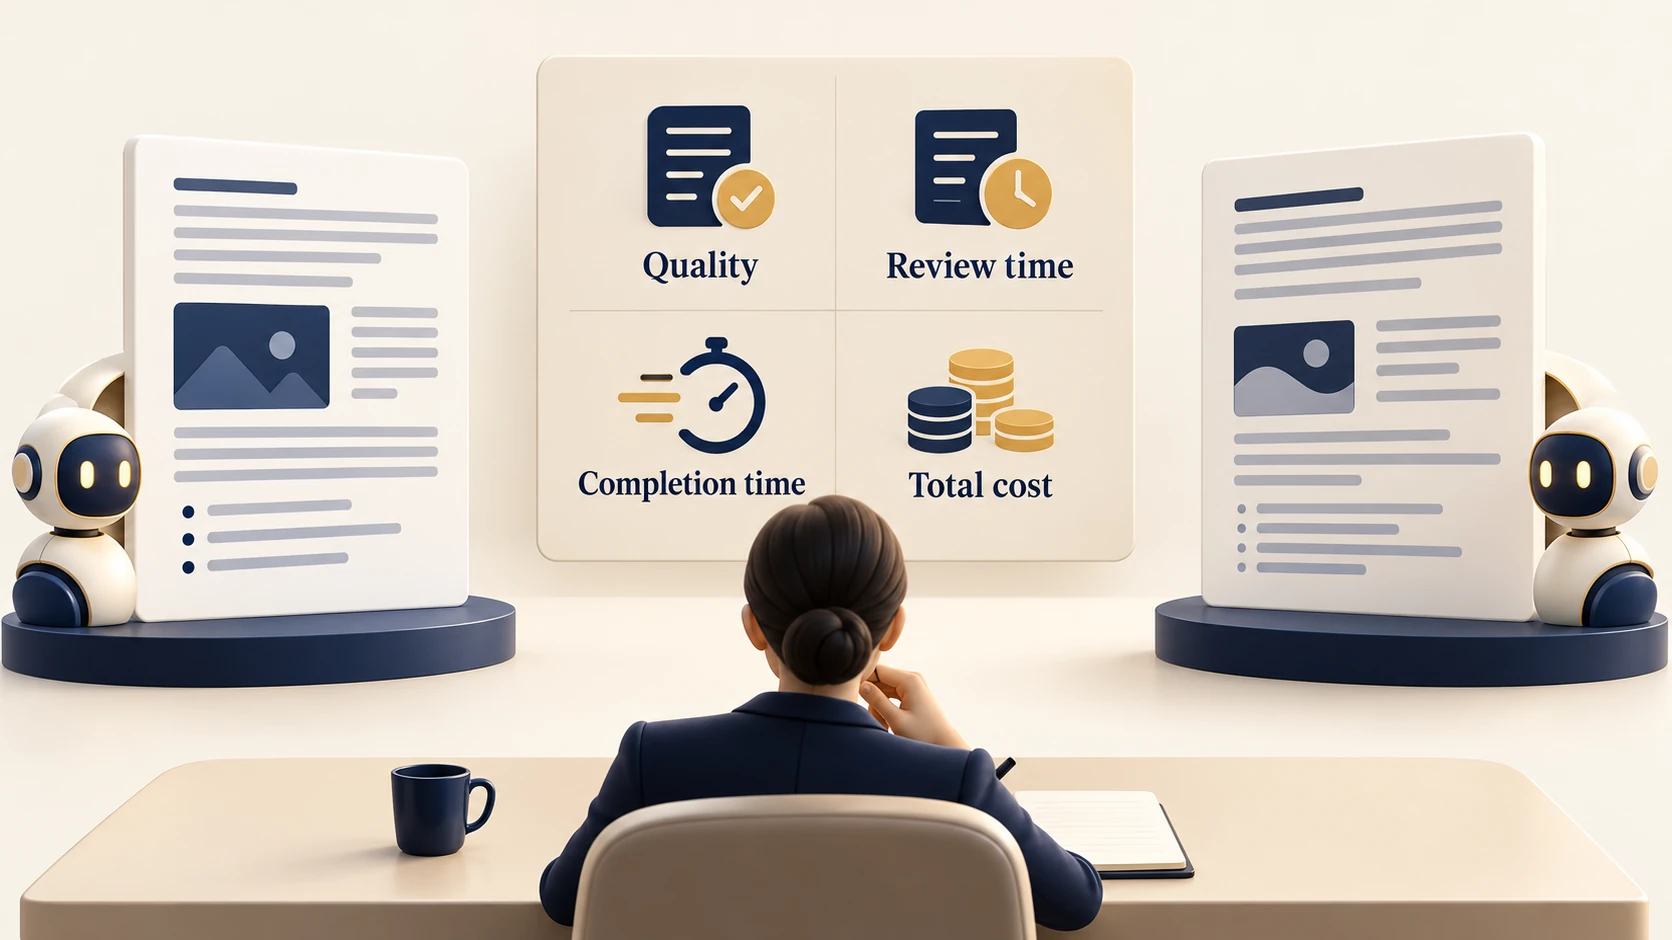
Para una elección final, usa una ficha de puntuación simple: salida aceptada, tiempo de corrección, tiempo de finalización y costo total. Pesa esos factores según el trabajo. Un equipo de investigación puede poner la calidad de la evidencia primero; un sistema de procesamiento por lotes puede preocuparse más por el costo una vez que se cumpla un umbral mínimo de calidad.
No hay necesidad de declarar ganador a un modelo en todas las tareas. Elige K3.1 Pro cuando entregue un resultado mejor para tus restricciones, y conserva Opus cuando tu evaluación respalde mantenerlo.