
Anthropic이 Claude Opus 5.5를 출시했으며, 새로운 Claude 5.5 패밀리의 첫 모델을 공개했습니다.
이번 업데이트는 까다로운 작업에 정면으로 맞춰졌습니다. 대규모 코딩 프로젝트, 장시간 실행되는 AI 에이전트, 리서치, 데이터 분석, 그리고 전문 지식 작업까지 폭넓게 지원합니다. Anthropic에 따르면 Opus 5.5는 많은 워크로드에서 Claude Fable 5.1급 성능에 도달하면서도, 이전 Opus 5에 비해 실행 비용은 상당히 낮습니다.
개발자 관점에서 주요 개선점은 단순히 더 높은 벤치마크 점수만이 아닙니다. Claude Opus 5.5는 토큰 비용 절감, 1 million-token 컨텍스트 창, 최대 128K 출력 토큰, 적응형 사고, 그리고 더 빠른 선택형 모드를 함께 제공합니다.
Claude Opus 5.5 한눈에 보기
| Specification | Claude Opus 5.5 |
|---|---|
| Release date | 2026년 9월 22일 |
| API model ID | claude-opus-5-5 |
| Context window | 1M 토큰 |
| Maximum output | 128K 토큰 |
| Batch API max output | 300K 토큰, 베타 |
| Input price | $4 / 1M tokens |
| Output price | $20 / 1M tokens |
| Cache read | $0.20 / 1M tokens |
| Thinking | Adaptive, always on |
| Default effort | Medium |
| Knowledge cutoff | 2026년 6월 |
| Input | 텍스트와 이미지 |
| Output | 텍스트 |
Anthropic은 Claude Opus 5.5를 최신 Opus 모델로 소개하며, 장시간 실행되는 에이전트형 코딩과 지식 작업을 위한 포지셔닝을 내세웠습니다.
Claude Opus 5.5에서 새롭게 추가된 기능은?
1. 길고 복잡한 코딩 작업에서 더 나은 성능
이번 릴리스에서 Anthropic이 집중하는 영역 중 하나가 바로 코딩입니다.
Opus 5.5는 고립된 코딩 질문에만 초점을 맞춘 것이 아니라, 여러 파일, 도구, 의사결정, 그리고 반복 단계가 포함될 수 있는 작업을 위해 설계됐습니다.
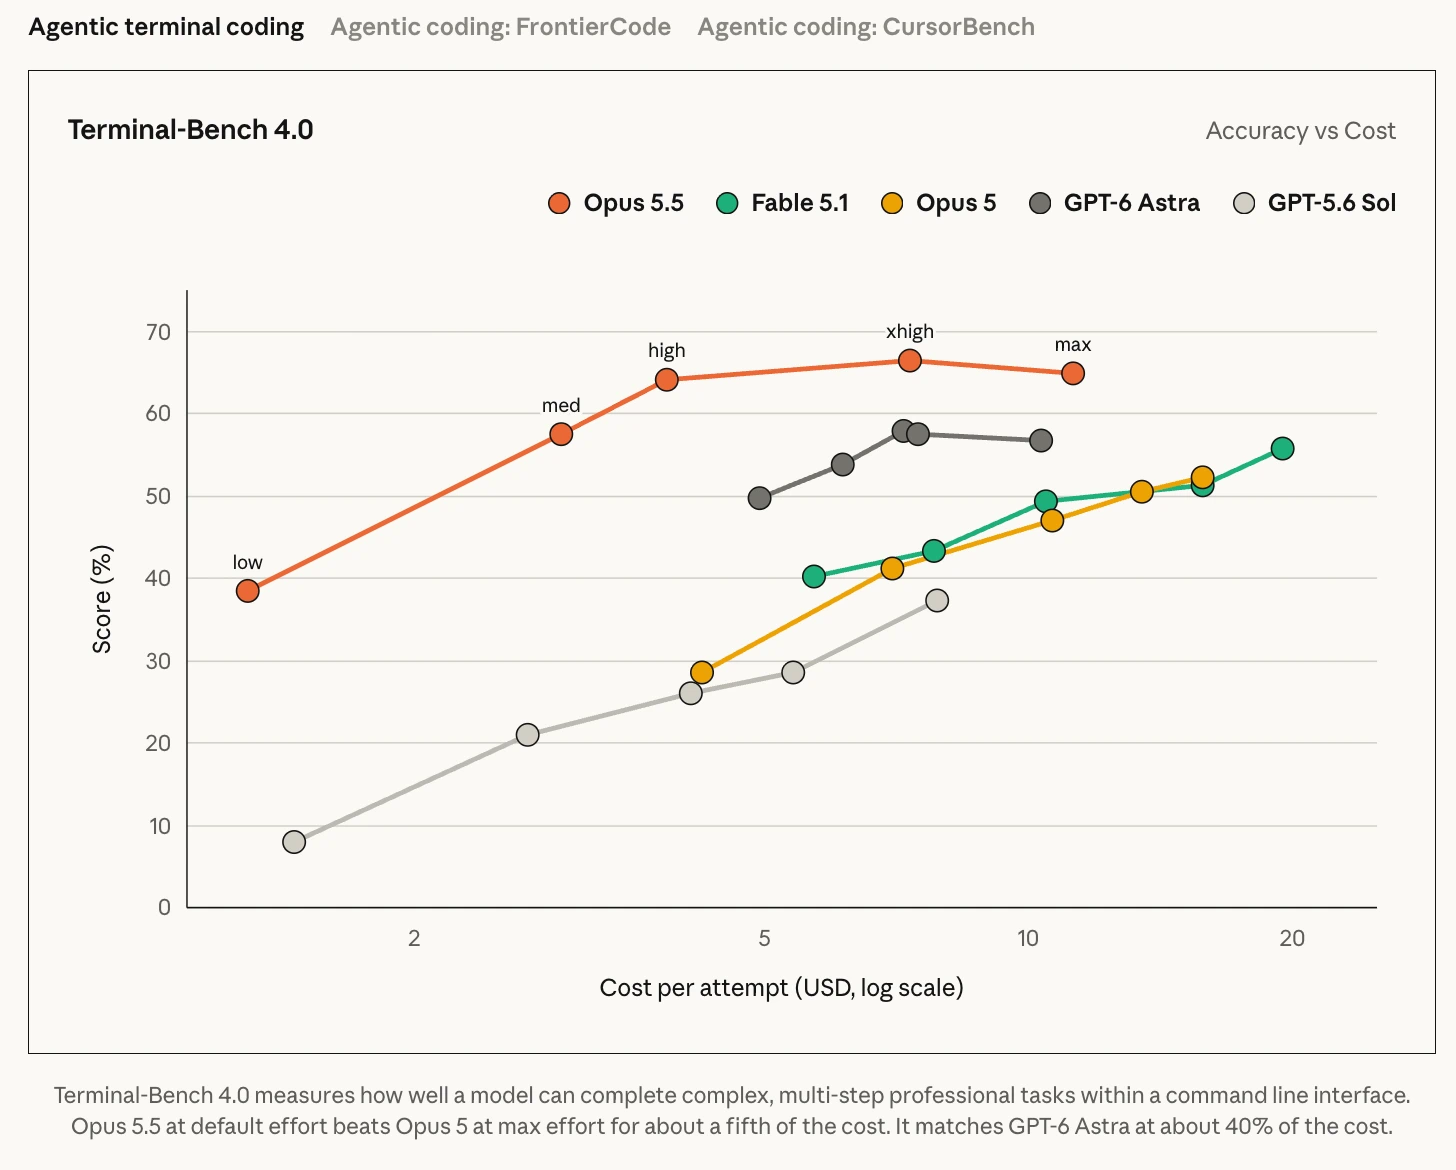
Anthropic은 초기 테스터가 이 모델로 20만 줄 규모의 코드베이스를 3시간 미만에 점검하고 수정했다고 보고합니다. 같은 예시에서 Opus 5는 20시간이 넘게 걸렸습니다. 또한 Anthropic은 HAProxy의 C-to-Rust 리라이트에서도 모델을 테스트했는데, Opus 5.5는 Fable 5.1보다 더 빠르게 작업을 완료했으며 보고된 비용도 더 낮았습니다.
- 대규모 코드베이스 마이그레이션
- 리포지토리 전반 리팩터링
- 여러 파일에 걸친 디버깅
- 자동화된 코드 리뷰
- 장시간 실행되는 코딩 에이전트
- 소프트웨어 유지보수 및 테스트
핵심은 단순히 “더 나은 코딩 답변”에 그치지 않는다는 점입니다. Claude가 여러 단계를 거쳐도 일관성을 유지해야 하는 엔지니어링 작업에 더욱 실용적으로 다가왔습니다.
Claude Opus 5.5 벤치마크
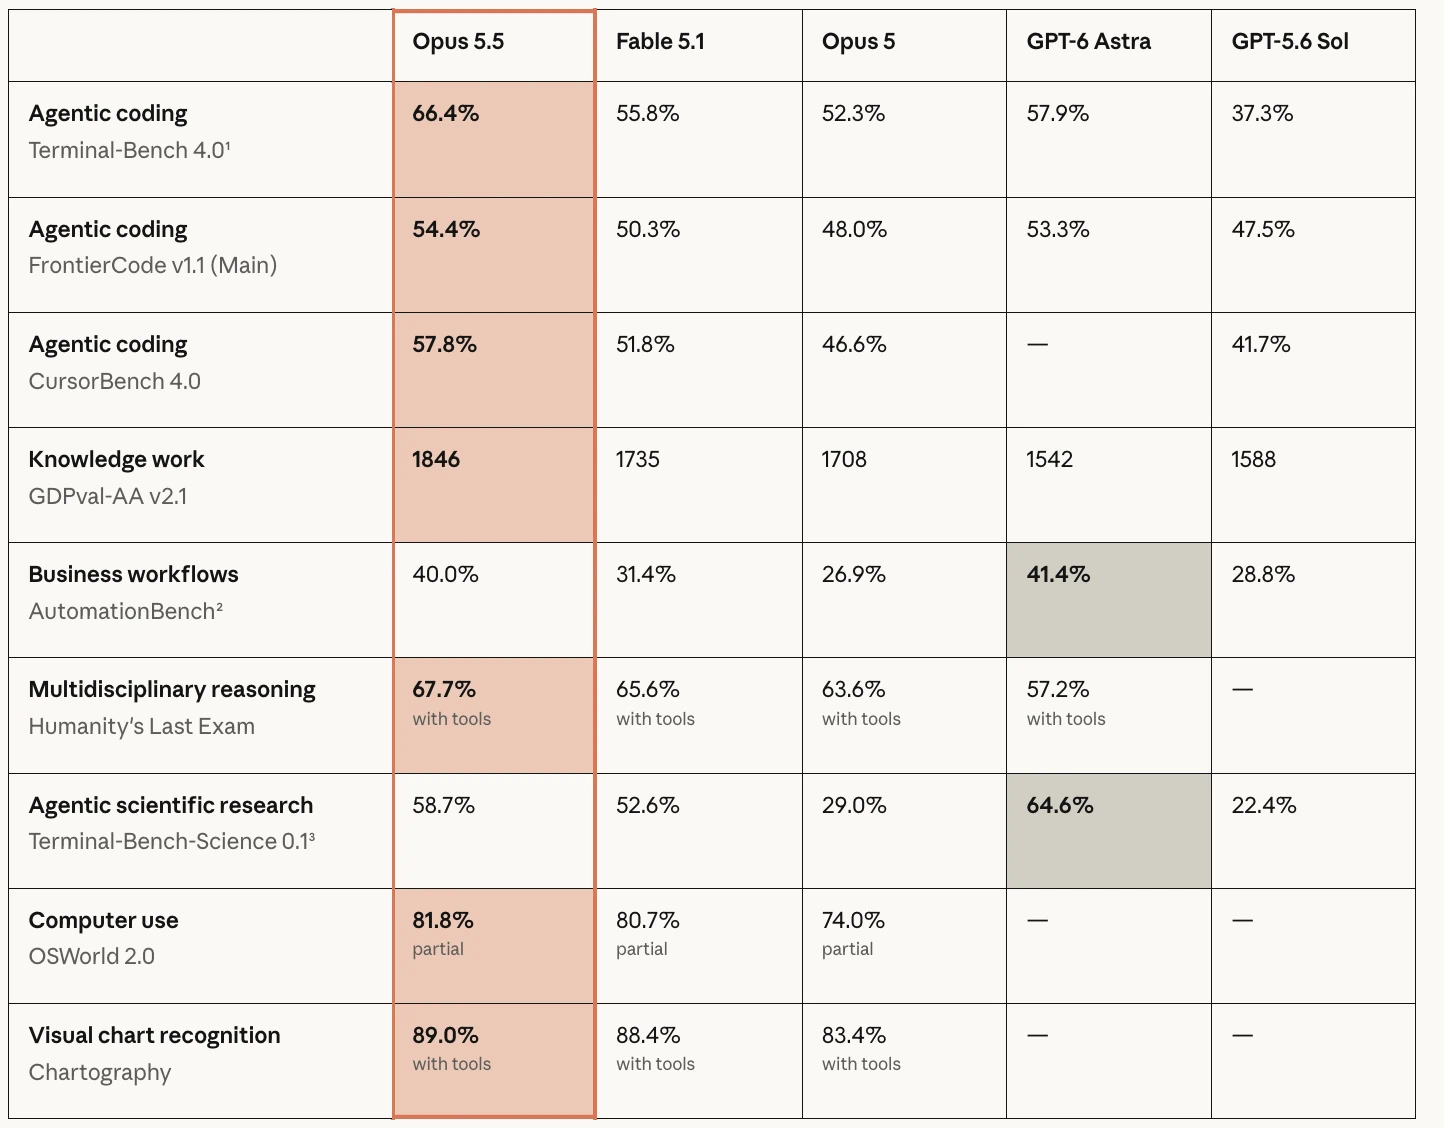
Anthropic은 코딩, 비즈니스 워크플로, 추론, 지식 작업, 그리고 컴퓨터 사용에 이르는 벤치마크 결과를 공개했습니다.
| Benchmark | Opus 5.5 | Opus 5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 52.3% | 57.9% |
| FrontierCode v1.1 | 54.4% | 48.0% | 53.3% |
| GDPval-AA v2.1 | 1846 | 1708 | 1542 |
| AutomationBench | 40.0% | 26.9% | 41.4% |
| Humanity’s Last Exam | 67.7% | 63.6% | 57.2% |
| Terminal-Bench-Science 0.1 | 58.7% | 29.0% | 64.6% |
이 수치들은 개별 벤치마크 결과가 왜 맥락을 필요로 하는지 보여줍니다. Opus 5.5는 Anthropic이 공개한 Terminal-Bench, FrontierCode, GDPval-AA, Humanity’s Last Exam 결과에서 GPT-6 Astra를 앞섭니다. 하지만 AutomationBench와 Terminal-Bench-Science에서는 같은 표에서 GPT-6 Astra 점수가 더 높습니다.
Claude Opus 5.5 가격
가격은 이번 업데이트에서 가장 중요한 개선 중 하나일 수 있습니다.
Claude Opus 5.5의 비용:
- 입력 토큰 100만 개당 $4
- 출력 토큰 100만 개당 $20
- 5분 캐시 쓰기 100만 개당 $5
- 캐시 읽기 100만 개당 $0.20
비교를 해보면 Claude Opus 5는 입력 토큰 100만 개당 $5, 출력 토큰 100만 개당 $25이며, Opus 5의 캐시 읽기 비용은 토큰 100만 개당 $0.50입니다.
| Model | Input | Output |
|---|---|---|
| Claude Opus 5.5 | $4 / 1M | $20 / 1M |
| Claude Opus 5 | $5 / 1M | $25 / 1M |
따라서 기본 토큰 단가는 20% 더 낮습니다. Anthropic은 Opus 5.5가 작업을 완료하는 데 필요한 토큰 수가 더 적은 경향도 있어, 전형적인 워크로드에서는 전체 비용이 약 40%까지 절감될 수 있다고 말합니다.
이 점은 도구를 반복 호출하고, 큰 컨텍스트를 읽으며, 장시간 실행하는 에이전트에서 특히 중요합니다.
1M 컨텍스트 창과 128K 출력
Claude Opus 5.5는 최근 Claude 모델에서 도입된 대용량 컨텍스트 기능을 유지합니다.
1 million-token 컨텍스트 창을 지원하며, 표준 요청에서 최대 128K 출력 토큰까지 제공합니다. Batch API 역시 베타로 최대 300K 출력 토큰을 지원합니다.
더 큰 컨텍스트 창은 다음과 같은 작업에서 유용할 수 있습니다:
- 대규모 코드 리포지토리
- 리서치 컬렉션
- 긴 보고서
- 여러 문서
- 계약 및 재무 관련 자료
- 확장된 에이전트 이력
문서 중심 워크플로의 경우, iWeaver AI Summarizer 같은 도구로도 방대한 PDF, 문서, 비디오, 기타 소스 자료를 더 깊은 분석에 앞서 구조화된 요약과 핵심 포인트로 바꾸는 데 도움이 됩니다.
Claude Opus 5.5 Fast Mode
지연 시간을 더 중요하게 보는 사용자라면 Fast Mode도 사용할 수 있습니다.
Anthropic은 Fast Mode를 사용하면 Claude Code 및 Claude Platform에서 Opus 5.5를 최대 표준 속도의 2.5배까지 실행할 수 있다고 말합니다.
대신 가격이 트레이드오프입니다:
- 입력 토큰 100만 개당 $8
- 출력 토큰 100만 개당 $40
표준 API 토큰 가격의 2배이므로, Fast Mode는 비용 최소화보다 응답 시간이 더 중요할 때 가장 적합합니다.
Claude Opus 5.5 vs Opus 5: 실제로 무엇이 달라졌나?
이번 업그레이드는 단순한 버전 번호 상승 이상의 의미가 있습니다.
Opus 5에 비해 Opus 5.5는 다음을 제공합니다:
| Area | Change |
|---|---|
| Coding | 장시간 실행 및 멀티 파일 작업에서 더 강함 |
| Agent workflows | 긴 작업 전반에서 더 나은 효율 |
| Input price | 100만 토큰당 $5 → $4 |
| Output price | 100만 토큰당 $25 → $20 |
| Cache reads | 100만 토큰당 $0.50 → $0.20 |
| Context | 1M 토큰 유지 |
| Maximum output | 128K 유지 |
| Thinking | 적응형 사고가 항상 켜짐 |
기존 Opus 5 애플리케이션을 마이그레이션하는 개발자는 Opus 5.5가 여러 행동(behavior) 변화도 함께 도입한다는 점을 확인해야 합니다. 예를 들어, 사고(thinking)는 더 이상 비활성화할 수 없고, 일부 도구 사용(tool-use) 동작도 변경되었습니다. Anthropic은 프로덕션 애플리케이션에서 모델 ID만 단순히 교체하기 전에 마이그레이션 문서를 확인할 것을 권장합니다.
Claude Opus 5.5는 어디에서 사용할 수 있나요?
Claude Opus 5.5는 다음을 사용해 Claude Platform에서 제공됩니다: claude-opus-5-5
Anthropic은 또한 Amazon Bedrock, Google Cloud, Microsoft Foundry, 그리고 AWS의 Claude Platform을 통한 지원도 함께 나열하고 있습니다. 소비자 대상 액세스는 지원되는 Claude 유료 요금제 전반에서 제공됩니다.
iWeaver에서 Claude Opus 5.5 사용해 보기
API를 설정하지 않고도 iWeaver에서 Claude Opus 5.5를 직접 테스트해 볼 수 있습니다. iWeaver는 무료 일일 크레딧을 제공하므로, 필요 여부를 결정하기 전 문서 분석, 리서치, 작성, 요약, 그리고 기타 지식 워크플로 같은 실제 작업으로 모델을 시험해볼 수 있습니다.
API 키, 과금, 개발 설정 관리는 필요 없이 Claude Opus 5.5를 먼저 경험해 보고 싶은 사용자라면, 간편하게 시작할 수 있는 좋은 방법입니다.
Claude Opus 5.5, 사용해볼 만한가요?
Claude Opus 5.5는 작업에 복잡하면서도 장시간 실행되는 태스크가 포함되어 있다면 가장 흥미로운 선택입니다.
짧은 질문이나 가벼운 생성만 필요한 경우에는 Opus 계열 모델을 쓰는 것이 여전히 불필요할 수 있습니다. 하지만 대규모 코딩 프로젝트, 문서 비중이 큰 리서치, 비즈니스 분석, 자율 에이전트, 그리고 실수가 나오거나 반복 재시도가 비용으로 이어지는 워크플로에서는, 더 강력한 성능과 더 낮은 토큰 비용의 조합이 분명한 차이를 만듭니다. 또한 이번 릴리스는 프론티어 모델들 사이의 경쟁 구도도 바꿉니다. Claude Opus 5.5는 이제 Anthropic의 최상위 Fable 계열 모델과 더 저렴한 Sonnet 계열 옵션 사이에 자리하면서, 고급 코딩 및 에이전트 워크로드에서 GPT-6 Astra 같은 모델과 직접 경쟁하게 됐습니다.
그래서 다음 비교가 특히 더 흥미롭습니다: Claude Opus 5.5 vs GPT-6.