
Grok 4.7이 공식 출시되었습니다. 2026년 9월 21일 공개된 Grok 4.7은 코딩, 에이전트형 작업, 전문 지식 업무를 위한 xAI의 최신 프런티어 모델입니다.
이 업데이트는 Grok 4.6의 단순한 소규모 개선을 넘어섭니다. xAI는 Grok 4.7이 새롭고 더 큰 기본 모델, 더 긴 강화학습 실행, 완료까지 몇 시간이 걸릴 수 있는 어려운 작업에 더 많은 비중을 두는 학습을 사용한다고 밝혔습니다. 또한 자체 검증과 롱컨텍스트 관리도 개선되었는데, 짧은 프롬프트에 답하는 것보다 실제 워크플로에서는 이 두 영역의 중요성이 훨씬 큽니다. 그리고 Grok 4.7을 둘러싼 초기 추측과 달리, 이제 비교할 수 있는 공식 스펙과 벤치마크 결과가 있습니다.
Grok 4.7 출시일
Grok 4.7이 공식적으로 런칭되었습니다. xAI API를 통해 다음과 같이 사용할 수 있습니다: grok-4.7
런칭과 함께 xAI는 Grok Build와 Cursor를 포함한 여러 코딩 및 AI 플랫폼에서도 이 모델을 제공했습니다. 또한 GitHub는 Grok 4.7을 GitHub Copilot 사용자들에게 순차적으로 배포하기 시작했습니다.
이전 세대에 대한 더 자세한 배경은 Grok 4.6 리뷰도 확인해 보세요.
Grok 4.7 스펙 한눈에 보기
다음은 주요 공식 스펙입니다.
| Specification | Grok 4.7 |
|---|---|
| Release date | 2026년 9월 21일 |
| Model name | grok-4.7 |
| Context window | 500,000 토큰 |
| Knowledge cutoff | 2026년 5월 |
| Input modalities | 텍스트 및 이미지 |
| Output modality | 텍스트 |
| Text output limit | 고정된 텍스트 출력 제한 없음 |
| Reasoning levels | Low, Medium, High, XHigh |
| Default reasoning | High |
| Function calling | 지원 |
| Web search | 지원 |
| X search | 지원 |
| Code execution | 지원 |
| API support | Responses API, Chat Completions |
500K 컨텍스트 윈도우는 긴 문서, 대규모 코드베이스, 멀티 파일 프로젝트, 그리고 시간이 지나도 많은 정보를 유지해야 하는 연구 작업 및 에이전트 워크플로에 특히 유용합니다.
Grok 4.7은 또한 네 가지 추론 레벨을 지원합니다:
- Low
- Medium
- High
- XHigh
이를 통해 개발자는 작업에 따라 속도와 추론 깊이를 서로 맞출 수 있습니다.
Grok 4.7의 새로운 점은?
가장 중요한 변화는 화려한 새 인터페이스 기능이 아닙니다.
핵심은 모델이 더 길고 더 어려운 작업을 처리하는 방식이 개선되었다는 점입니다.
1. 새롭고 더 큰 기본 모델
Grok 4.7은 Grok 4.6과 비교해 더 새롭고 더 큰 기본 모델을 기반으로 구축되었습니다.
이는 단순히 Grok 4.6에 추가적인 사후 학습을 얹은 형태가 아니라는 의미입니다.
기반 모델 자체가 변경되었습니다.
그다음 xAI는 더 어려운 작업 구성으로 더 긴 강화학습 실행을 진행했고, 완료까지 많은 시간이 걸릴 수 있는 문제에 더 큰 비중을 두었습니다.
목표는 분명합니다:
어렵고 힘든 작업을 ‘잘 시작’하는 것뿐 아니라, ‘끝까지 해내는’ Grok를 만들기.
2. 더 나은 롱태스크 성능
많은 AI 모델은 짧은 프롬프트에서는 인상적으로 보이지만, 작업이 길어질수록 신뢰도가 떨어지곤 합니다.
그 징후는 다음과 같이 나타날 수 있습니다:
- 잊혀진 지시사항
- 일관되지 않은 판단
- 반복 작업
- 놓친 의존성
- 확인되지 않는 오류
- 이전 컨텍스트의 활용이 부실함
Grok 4.7은 특히 더 오래 실행되는 작업에서 더 잘 수행하도록 학습되었습니다.
이는 코딩 에이전트, 연구 워크플로, 문서 생성, 그리고 여러 단계를 포함하는 전문 업무에 특히 중요합니다.
3. 더 나은 자체 검증
또 하나의 중요한 변화는 더 강력한 자기 점검입니다.
단순히 답을 생성한 뒤 그만두는 대신, Grok 4.7은 자신의 작업을 더 신중하게 검증하도록 설계되었습니다.
이는 예를 들어 다음과 같은 작업에서 중요합니다:
- 코드 디버깅
- 대규모 프로젝트 편집
- 계산 결과 확인
- 문서 검토
- 긴 지시사항을 따르기
- 여러 도구를 순서대로 사용하기
물론 자체 검증이 모델이 실수를 못 한다는 뜻은 아닙니다.
중요한 의사결정이 걸린 작업에서는 사람의 검토는 여전히 중요합니다.
하지만 더 나은 내부 점검은 긴 워크플로 동안 눈에 띄는 실패를 줄이는 데 도움이 될 수 있습니다.
4. 더 강력한 에이전트 및 지식 업무
Grok 4.7은 또한 xAI의 Grok Bot을 더 잘 이해하도록 학습되었습니다.
이로 인해 AI가 단 하나의 질문에 답하는 수준을 넘어 더 많은 일을 해야 하는 에이전트형 작업에서 특히 활용도가 높습니다.
예를 들어:
- 파일을 살펴보기
- 정보를 검색하기
- 코드를 작성하기
- 도구를 실행하기
- 결과를 검토하기
- 자신의 작업을 수정하기
- 더 큰 작업이 완료될 때까지 계속하기
이는 프런티어 AI 전반에서 나타나는 더 큰 변화의 흐름을 반영합니다.
핵심 질문은 더 이상 단순히:
모델이 이 질문에 답할 수 있나?
가 아닙니다.
점점 이렇게 바뀝니다:
모델이 전체 작업을 끝까지 완료할 수 있나?
Grok 4.7 벤치마크
xAI는 Grok 4.7을 Grok 4.6 및 기타 프런티어 모델과 비교한 벤치마크 결과를 공개했습니다.
결과는 특히 코딩, 터미널 기반 작업, 엔지니어링, 그리고 전문 지식 업무에서 두드러진 개선을 보여줍니다.
가장 깔끔한 비교를 위해, 아래 표는 Grok 4.7 vs Grok 4.6에 집중합니다.
| Benchmark | Grok 4.7 | Grok 4.6 | Change |
|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | +5.9 pts |
| DeepSWE v1.1 | 71.0% | 65.2% | +5.8 pts |
| AA Briefcase v1.1 | 1,657 | 1,546 | +111 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | +17.7 pts |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | +3.8 pts |
| HealthBench Professional | 56.7% | 48.5% | +8.2 pts |
| EEBench | 64.0% | 53.0% | +11.0 pts |
이 세트에서 가장 큰 점프는 Terminal-Bench 4.0에서 나타나는데, Grok 4.7은 20.3%의 Grok 4.6과 비교해 38.0%를 기록했습니다.
이는 터미널 명령, 도구, 저장소, 그리고 멀티 스텝 실행을 포함하는 에이전트형 코딩 워크플로와 특히 관련이 큽니다.
또한 Grok 4.7은 전기공학, 전문 지식 업무, 소프트웨어 엔지니어링, 임상 추론 벤치마크에서도 눈에 띄는 향상을 보입니다.
Grok 4.7 vs Grok 4.6
벤치마크 수치만 보면 세대 간 변화가 더 명확하게 보입니다.
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| Status | 이전 세대 | 최신 세대 |
| Base model | 이전 모델 | 새롭고 더 큰 기본 모델 |
| Context window | — | 500K 토큰 |
| Long-running tasks | 강함 | 개선 |
| Self-verification | 강함 | 개선 |
| CursorBench 4.0 | 40.4% | 46.3% |
| DeepSWE v1.1 | 65.2% | 71.0% |
| Terminal-Bench 4.0 | 20.3% | 38.0% |
| EEBench | 53.0% | 64.0% |
| API input price | $2 / 1M 토큰 | $2 / 1M 토큰부터 |
| API output price | $6 / 1M 토큰 | $6 / 1M 토큰부터 |
따라서 Grok 4.6에서 Grok 4.7로 옮길 가장 큰 이유는 단 하나의 대표 기능 때문은 아닙니다.
이는 다음의 조합입니다:
더 나은 코딩 + 더 강력한 롱태스크 성능 + 더 나은 컨텍스트 관리 + 더 강력한 자체 점검.
일상의 짧은 질문 위주로 업무를 한다면 그 차이는 상대적으로 작게 느껴질 수 있습니다.
하지만 긴 멀티 스텝 워크플로를 실행하는 개발자와 사용자에게는 이번 개선의 의미가 더 큽니다.
Grok 4.7 가격
Grok 4.7 시작 가격은 다음과 같습니다:
- 입력 100만 토큰당 $2
- 캐시된 입력 100만 토큰당 $0.50
- 출력 100만 토큰당 $6
이 요금은 프롬프트가 200K 토큰 미만일 때 적용됩니다.
200K 토큰을 초과하는 프롬프트의 경우, 공식 API 가격은 다음과 같이 인상됩니다:
- 입력 100만 토큰당 $4
- 캐시된 입력 100만 토큰당 $1
- 출력 100만 토큰당 $12
이 단계형 가격을 주목할 만한 이유는 Grok 4.7의 컨텍스트 윈도우가 500K이기 때문입니다.
따라서 전체 컨텍스트 윈도우를 사용하면 더 짧은 요청보다 비용이 더 들 수 있습니다.
Grok 4.7 Fast란?
xAI는 Grok 4.7 Fast도 제공합니다.
이는 더 빠른 인프라에서 제공되는 동일한 기본 모델입니다.
xAI에 따르면 표준 토큰 요금의 2배 기준으로 출력 속도가 약 2배 제공됩니다.
다만 중요한 사용 가능 여부 차이가 있습니다:
Grok 4.7 Fast는 현재 Cursor와 Grok Build에서 사용할 수 있지만, 공개 xAI API에서는 제공되지 않습니다.
따라서 xAI API로 직접 구축하는 개발자에게는 표준 Grok 4.7 모델이 주요 선택지가 됩니다.
Grok 4.7은 어디에서 사용할 수 있나요?
Grok 4.7은 이미 여러 플랫폼에서 제공되고 있습니다.
xAI API
개발자는 다음을 사용할 수 있습니다:
grok-4.7
xAI Responses API 또는 Chat Completions API를 통해서입니다.
다음과 같은 도구를 지원합니다:
- 함수 호출
- 웹 검색
- X 검색
- 코드 실행
Grok Build
Grok 4.7은 xAI의 코딩 및 앱 빌딩 에이전트인 Grok Build의 기본 모델입니다.
Cursor
Grok 4.7은 Cursor에서 사용할 수 있습니다.
Fast 버전도 거기에서 사용할 수 있습니다.
모델 게이트웨이
xAI 문서에는 다음을 포함한 플랫폼에서의 사용 가능 여부가 나열되어 있습니다:
- OpenRouter
- Vercel
- Cloudflare
GitHub Copilot
GitHub는 9월 21일에 GitHub Copilot에 Grok 4.7을 순차 배포하기 시작했습니다.
Copilot Pro, Pro+, Max, Business, Enterprise 요금제 전반에 걸쳐 제공될 예정입니다.
지원 환경은 다음을 포함합니다:
- Visual Studio Code
- Visual Studio
- Copilot CLI
- GitHub Copilot 클라우드 에이전트
- GitHub Copilot 앱
- JetBrains
- Xcode
- Eclipse
배포는 점진적으로 진행되므로 일부 사용자는 즉시 확인하지 못할 수 있습니다.
Grok 4.7은 단 하나의 벤치마크로 판단하지 마세요
공식 결과는 유용하지만, 벤치마크 표만으로 모델을 최종 선택하는 것은 옳지 않습니다.
서로 다른 벤치마크는 서로 다른 것들을 테스트합니다.
코딩 벤치마크에서 잘하는 모델이 반드시 다음 분야에서 최선의 선택이라고 볼 수는 없습니다:
- 연구
- 문서 분석
- 글쓰기
- 고객 지원
- 데이터 추출
- 요약
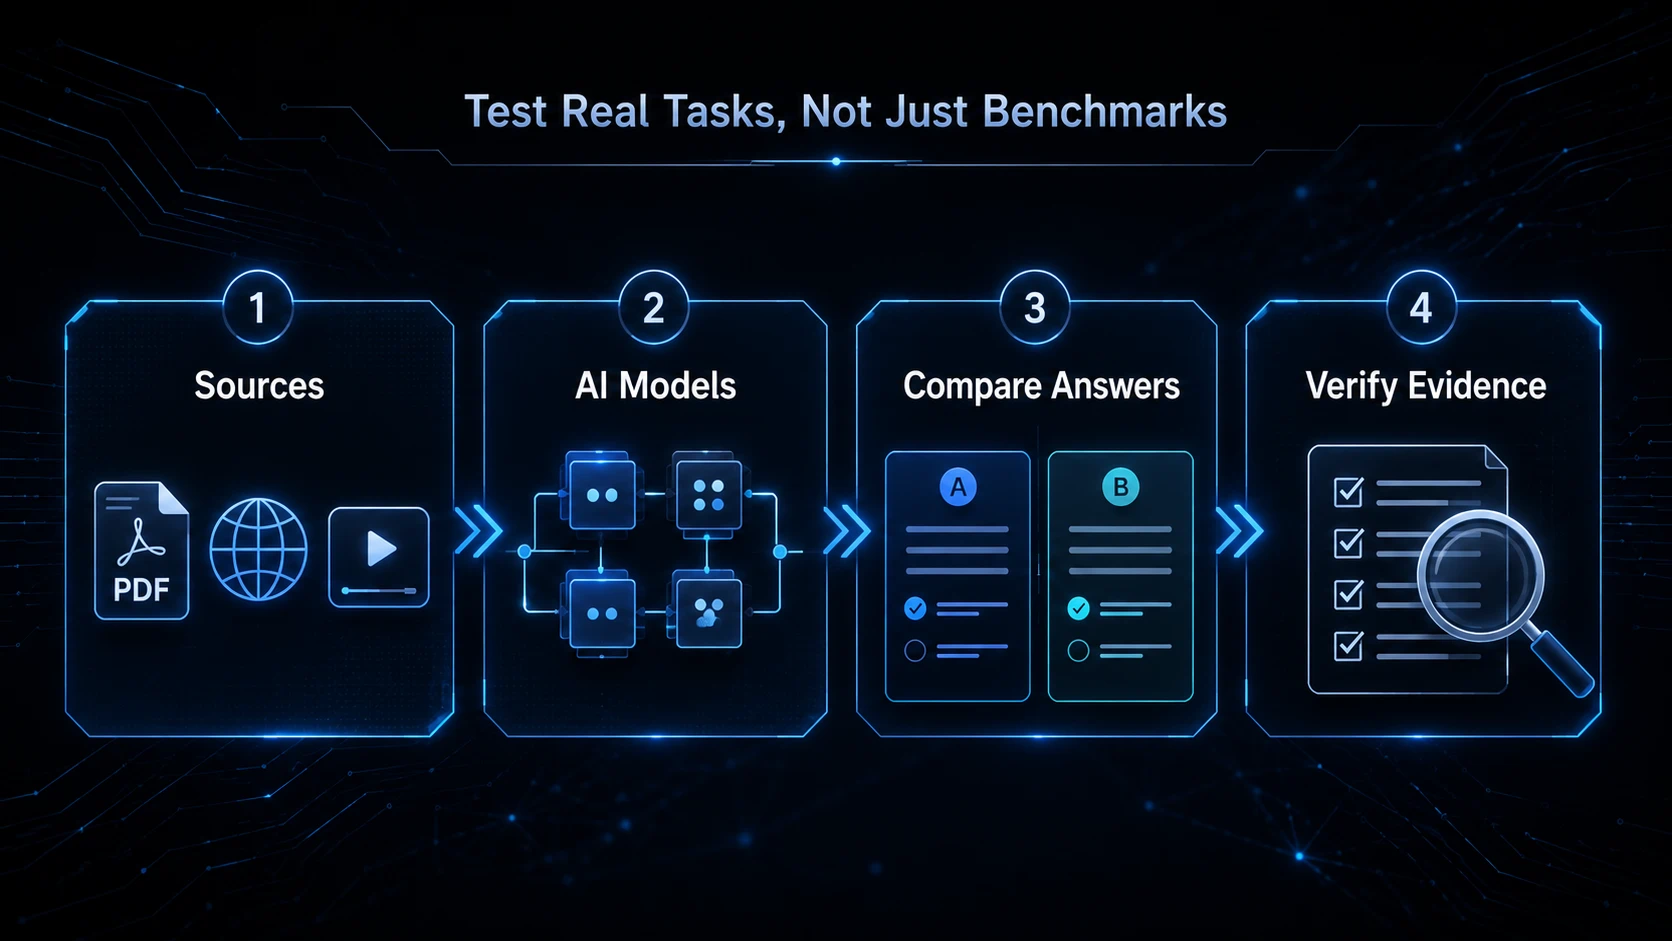
더 나은 방법은 동일한 실제 작업으로 모델을 비교하는 것입니다.
예를 들어:
- 각 모델에 동일한 질문을 제공합니다.
- 동일한 소스 파일을 제공합니다.
- 동일한 지시사항을 사용합니다.
- 최종 답변을 비교합니다.
- 누락된 정보와 사실 오류를 확인합니다.
- 중요한 결론을 원본 소스와 대조해 검증합니다.
업무에 PDF, 웹사이트, 비디오, 프레젠테이션, 연구 문서가 포함된다면, 모델 출력을 비교하기 전에 iWeaver 같은 도구로 해당 자료를 한곳에서 정리하는 데 도움이 될 수 있습니다.
이렇게 하면 AI 모델이 실제로 내 워크플로에 유용한지—단순히 리더보드에서 더 좋아 보이는지—를 더 쉽게 판단할 수 있습니다.
Grok 4.7을 써볼 만한가요?
코딩 및 에이전트형 워크플로라면 Grok 4.7은 Grok 4.6에 비해 의미 있는 업데이트입니다.
공식 벤치마크 데이터는 소프트웨어 엔지니어링, 터미널 작업, 전문 작업, 전기공학, 법률 작업, 임상 추론 전반에서 개선을 보여줍니다.
또한 500K 컨텍스트 윈도우, 더 강력한 롱태스크 성능, 향상된 자체 검증, 도구 지원, 그리고 시작 API 가격이 그대로 유지된 점까지 더해져, 더 큰 워크플로에 더 실용적입니다.
그렇다고 Grok 4.7이 모든 작업에서 최고의 모델이 될 거라는 뜻은 아닙니다.
모델마다 강점은 다르며, 벤치마크 결과가 항상 실제 결과물의 향상으로 그대로 이어지지는 않습니다.
하지만 Grok 4.7은 특히 작업에 많은 단계가 필요하거나, 큰 양의 컨텍스트가 필요하거나, 도구 사용이 길게 이어질 때—Grok 4.6보다 개발자와 전문 사용자에게 더 강력한 선택지를 제공합니다.
Grok 4.7은 단순히 또 하나의 작은 Grok 업데이트가 아닙니다.
새롭고 더 큰 기본 모델을 사용하며, 롱런 코딩, 에이전트형 작업, 자체 검증, 전문 지식 작업에 훨씬 더 많은 비중을 둡니다.
Grok 4.6과 비교하면, 공식 수치에서는 여러 까다로운 벤치마크에서 뚜렷한 개선이 확인되는 동시에 시작 API 가격은 그대로 유지됩니다.
이제 더 흥미로운 질문은 Grok 4.7이 종이 위에서 Grok 4.6보다 더 잘하는지가 아닙니다.
그 개선이 실제 프로젝트에서 얼마나 이어지는지입니다.
더 긴 AI 워크플로를 만드는 개발자, 연구자, 사용자에게 Grok 4.7은 궁극적으로 그 지점에서 검증될 것입니다.