“사진 요약”은 매우 다른 의미를 가질 수 있습니다.
어떤 학생은 촬영한 교재 페이지의 요약을 원할 수 있습니다. 제품 관리자는 대시보드 스크린샷에서 핵심 메시지가 필요할 수 있습니다. 개발자는 수천 장의 이미지 전반에서 텍스트, 객체, 라벨을 감지하는 API를 원할 수 있습니다.
하지만 이는 같은 작업이 아닙니다.
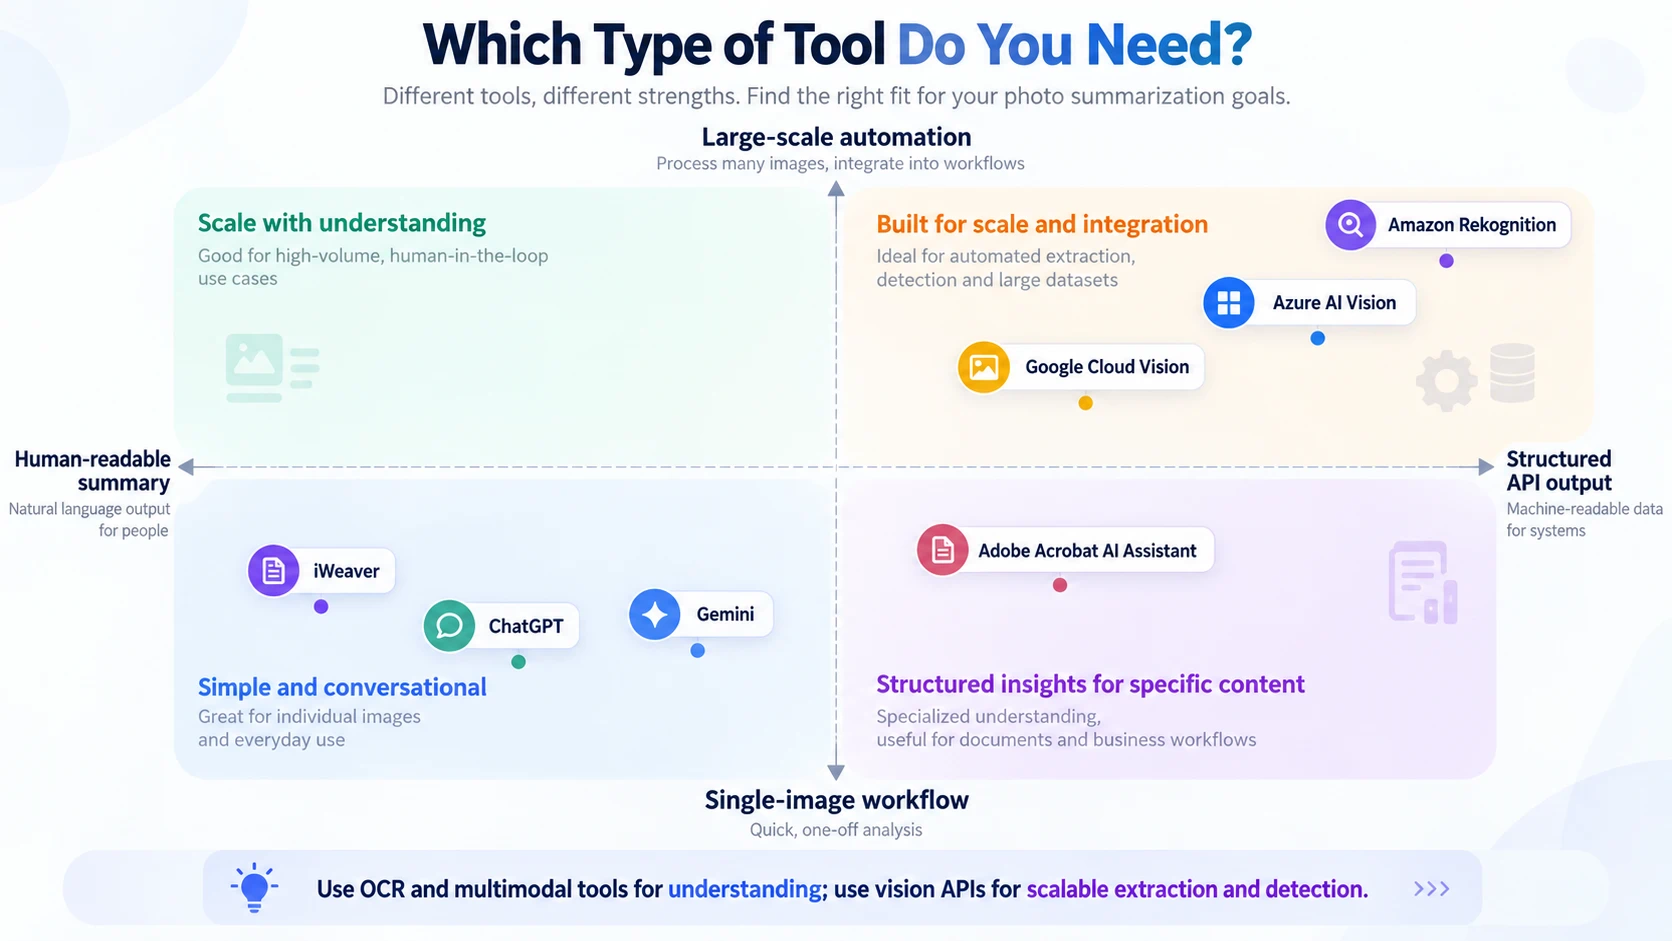
따라서 가장 좋은 AI 사진 요약 도구는 읽기 쉬운 자연어 요약이 필요한지, OCR이 필요한지, 시각적 추론이 필요한지, 또는 구조화된 컴퓨터 비전 출력이 필요한지에 따라 달라집니다.
이 2026년 비교는 이러한 사용 사례를 분리해, 올바른 유형의 도구를 선택할 수 있도록 돕습니다.
빠른 비교
| 도구 | 가장 적합한 대상 | 추출할 수 있는 것 | 최적의 사용자 |
|---|---|---|---|
| iWeaver | 구조화된 이미지 요약 | 텍스트, 시각적 맥락, 차트, 노트 | 지식 노동자 및 학생 |
| ChatGPT | 대화형 이미지 분석 | 텍스트, 객체, 다이어그램, 스크린샷 | 일반 사용자 |
| Gemini | 이미지 Q&A 및 시각적 이해 | 사진, 텍스트, 시각적 맥락 | 일반 사용자 |
| Adobe Acrobat AI Assistant | 스캔 문서 및 PDF 이미지 | OCR + 문서 수준 맥락 | PDF 중심 사용자 |
| Google Cloud Vision | OCR 및 머신 비전 API | 텍스트, 라벨, 객체, 랜드마크 | 개발자 |
| Azure AI Vision | OCR, 캡션, 이미지 분석 | 텍스트, 캡션, 객체 | 개발자 및 기업 |
| Amazon Rekognition | 대규모 이미지 탐지 | 라벨, 객체, 텍스트, 모더레이션 신호 | 개발자 및 AWS 팀 |
1. iWeaver — 구조화된 이미지 요약에 가장 적합
iWeaver의 AI 이미지 요약기는 이미지 안에 무엇이 들어있는지만 감지하는 게 아니라, 이미지를 이해하려는 사람들을 위해 설계되었습니다.
다음과 같이 사용할 수 있습니다:
- 스크린샷
- 차트
- 시각적 노트
- 스캔 페이지
- 인포그래픽
- 프레젠테이션 슬라이드
- 텍스트가 포함된 이미지
유용한 차이는 ‘출력 구조’입니다. OCR 텍스트나 라벨만 반환하는 대신, 이 도구는 이미지를 핵심 포인트, 설명, 노트, 후속 질문에 대한 답변으로 변환할 수 있습니다.
그래서 연구, 공부, 비즈니스 리뷰, 지식 워크플로에 실제적으로 활용하기 좋습니다.
이럴 때 선택하세요: 계속 작업할 수 있는 사람이 읽기 쉬운 요약을 원할 때.
2. ChatGPT — 대화형 이미지 분석에 가장 적합
ChatGPT는 업로드한 이미지를 분석하고, 보이는 콘텐츠에 대해 질문에 답할 수 있습니다.
첫 번째 요약이 더 많은 질문으로 이어질 때 특히 유용합니다.
예를 들어:
이 대시보드를 다섯 가지 핵심으로 요약해줘.
그다음:
어떤 지표가 가장 많이 변했어?
그다음:
그 결과를 우리 팀을 위한 짧은 업데이트로 바꿔줘.
이 방식은 다이어그램, 스크린샷, 사진으로 찍은 문서, 그리고 다양한 시각적 입력에도 동일하게 적용됩니다.
강점은 고정된 ‘사진 요약’ 형식이 아니라 유연성입니다.
중요한 디테일의 경우, 숫자·라벨·작은 글자를 원본 이미지와 대조해 확인하세요.
이럴 때 선택하세요: 이미지를 대화식으로 논의하고, 그 결과를 다른 출력으로 변환하고 싶을 때.
3. Gemini — 일반 이미지 Q&A에 가장 적합
Gemini는 이미지 업로드를 지원하며, 사진과 시각적 콘텐츠에 대해 질문에 답할 수 있습니다.
일상적인 사용에서는 다음 같은 작업에 적합합니다:
- 스크린샷에 무엇이 보이는지 설명하기
- 이미지에서 텍스트 읽기
- 사진으로 찍은 페이지 요약하기
- 보이는 요소 식별하기
- 여러 시각적 디테일 비교하기
또한 구글의 시각 생태계는 Lens와 이미지 이해 분야에서 쌓아온 긴 역사 덕분에 더 큰 이점을 제공합니다.
어떤 멀티모달 보조도 그렇듯, 좋은 프롬프트는 ‘관찰’과 ‘해석’을 분리해야 합니다.
예를 들어:
먼저 눈에 보이는 항목을 나열해줘. 그다음 핵심 메시지를 요약해줘. 읽기 어려운 텍스트는 표시해줘.
이럴 때 선택하세요: 빠른 분석을 위한 범용 시각 보조를 원할 때.
4. Adobe Acrobat AI Assistant — 스캔 문서에 가장 적합
“사진”은 종종 실제로는 문서 페이지를 이미지로 캡처한 경우입니다.
입력이 스캔된 PDF, 리포트, 계약서, 아카이브 문서라면, 일반적인 사진 분석기보다 Adobe Acrobat AI Assistant가 더 잘 맞을 수 있습니다.
이 워크플로는 OCR과 문서 컨텍스트를 결합해, 파일을 개별 이미지로 분리하지 않고도 스캔된 텍스트에서 요약과 질문으로 이어질 수 있게 합니다.
특히 페이지 순서와 문서 구조가 중요한 경우에 유용합니다.
이럴 때 선택하세요: 이미지가 주로 PDF 안의 페이지인 경우.
5. Google Cloud Vision — OCR 및 이미지 API에 가장 적합
Google Cloud Vision은 소비자용 요약 작성 도구가 아닙니다. 개발자를 위한 컴퓨터 비전 서비스입니다.
인쇄된 텍스트나 손글씨 텍스트를 감지하고, 라벨과 기타 시각적 신호를 포함해 이미지에 대한 구조화된 정보를 반환할 수 있습니다.
그래서 나만의 요약 파이프라인을 구축해야 할 때 유용합니다.
일반적인 워크플로는 다음과 같습니다:
이미지 → Cloud Vision OCR/라벨 → 구조화 데이터 → 언어 모델 → 최종 요약
이를 통해 개발자는 추출, 저장, 신뢰도 체크, 그리고 후속 처리(다운스트림 처리)를 직접 제어할 수 있습니다.
수동 업로드 도구로는 비현실적인 대규모 자동화에 특히 유용합니다.
이럴 때 선택하세요: API를 통해 이미지 이해가 필요한 애플리케이션을 만들고 있을 때.
6. Azure AI Vision — 엔터프라이즈 컴퓨터 비전에 가장 적합
Azure AI Vision은 Microsoft 중심의 개발 환경을 위한 OCR 및 이미지 분석 기능을 제공합니다.
사용하는 서비스와 모델에 따라 텍스트를 추출하고, 시각적 요소를 식별하며, 더 큰 AI 워크플로로 전달할 수 있는 설명형 정보를 생성할 수 있습니다.
기업 팀에게 가장 큰 가치는 ‘통합’입니다. 이미지 분석은 저장, 검색, 자동화, 언어 모델을 포함하는 더 넓은 Azure 아키텍처의 한 구성 요소가 될 수 있습니다.
단일 스크린샷을 업로드하고 깔끔한 연구 요약을 받는 경험과는 다릅니다.
이럴 때 선택하세요: 조직에서 Azure 기반 시스템에 이미지 처리를 구축하고 있을 때.
7. Amazon Rekognition — AWS 이미지 탐지 워크플로에 가장 적합
Amazon Rekognition은 또 다른 개발자 중심 옵션입니다.
이미지 전반에서 라벨, 객체, 텍스트 및 기타 시각적 신호를 감지할 수 있습니다. 이미 AWS를 사용 중인 팀은 그 구조화된 출력을 데이터베이스, 모더레이션 시스템, 검색 파이프라인, 언어 모델로 연결할 수 있습니다.
‘요약’의 관점에서 Rekognition은 보통 최종 ‘작성’ 단계라기보다 인식(지각) 계층 역할을 합니다.
이 구분은 중요합니다. 컴퓨터 비전 API는 이미지에 사람이, 자전거가, 도로가, 그리고 텍스트가 포함되어 있다고 알려줄 수 있습니다. 반면 멀티모달 언어 도구는 그 관찰 내용을 자연어 설명으로 바꾸는 데 더 적합합니다.
이럴 때 선택하세요: AWS 워크플로 내부에서 확장 가능한 이미지 분석이 필요할 때.
이미지 요약기 vs. OCR 도구: 차이점은 무엇인가요?
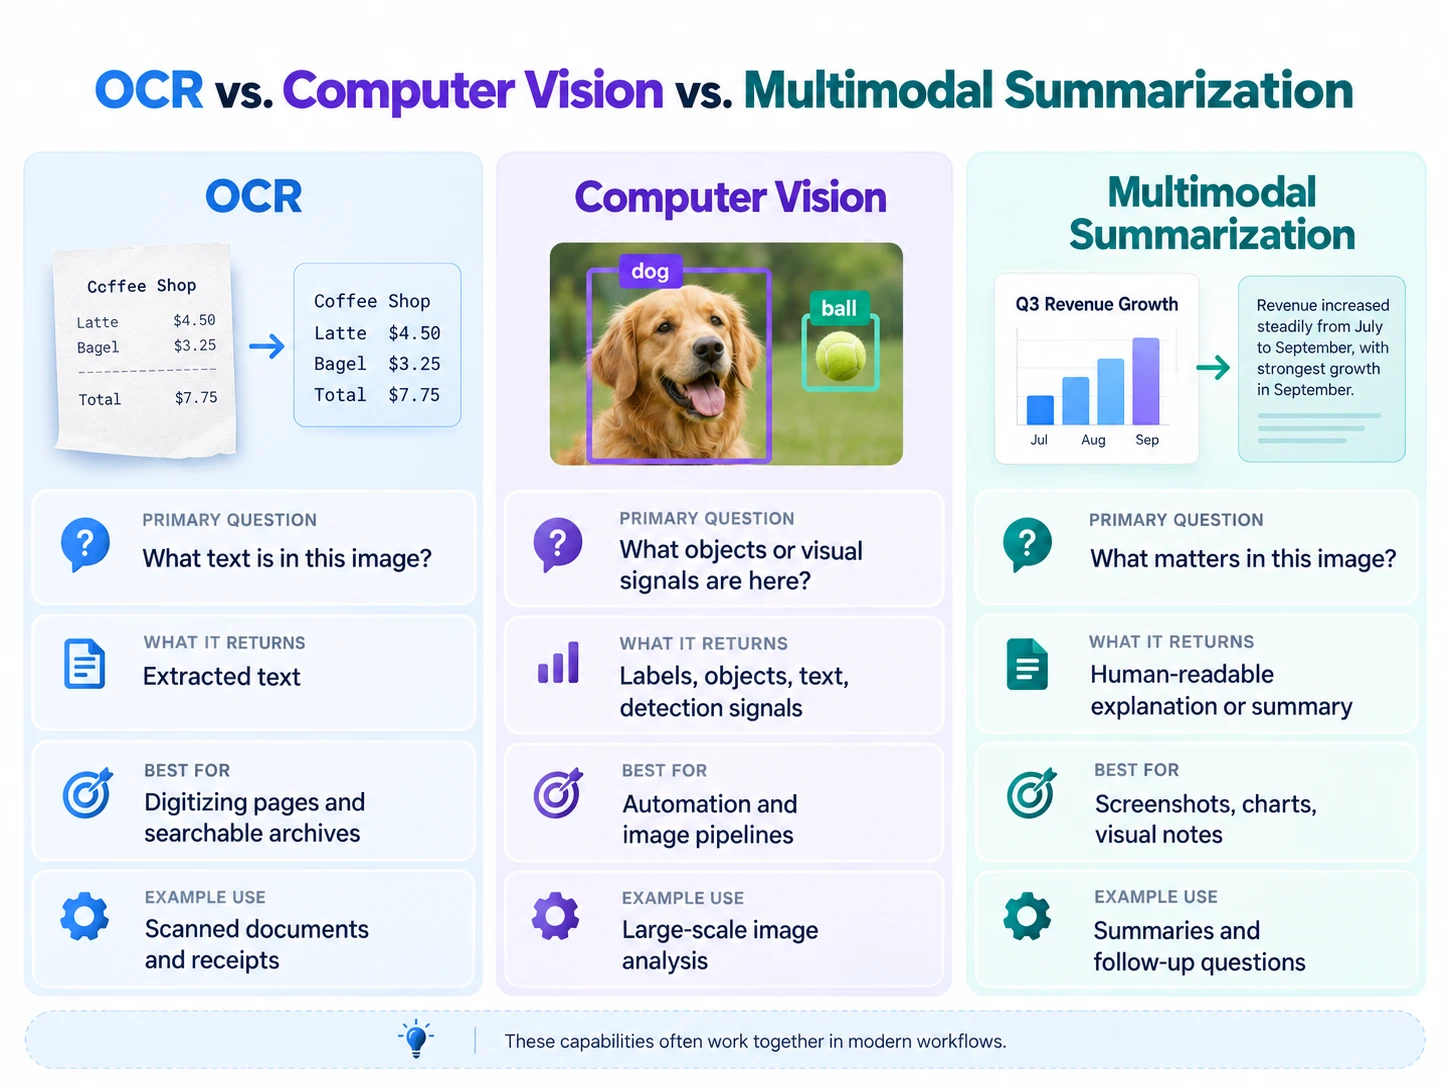
OCR은:
이 이미지 안에 어떤 텍스트가 있나요?
이미지 요약기는:
이 이미지에서 중요한 건 무엇인가요?
멀티모달 보조는 더 나아갈 수 있습니다:
제 질문의 맥락에서 이 이미지는 무엇을 의미하나요?
이 기능들은 겹치지만, 완전히 같지는 않습니다.
인쇄된 텍스트만 디지털화하면 된다면 OCR로 충분할 수 있습니다. 스크린샷, 차트, 시각적 노트의 핵심을 간결하게 설명해야 한다면 텍스트와 레이아웃을 모두 이해하는 도구를 사용하세요.
단계별 워크플로는 이미지에서 텍스트를 요약하는 방법을 참고하세요.
올바른 도구를 고르는 방법
네 가지 질문을 해보세요.
1. 중요한 정보는 대부분 텍스트인가요?
그렇다면 OCR 품질을 우선시하세요.
손글씨 자료라면 전문화된 AI 손글씨 인식 워크플로를 사용하거나, 손글씨를 위해 설계된 다른 OCR 도구를 사용하세요.
2. 레이아웃이 중요한가요?
차트, 대시보드, 슬라이드 덱, 인포그래픽에서는 텍스트 추출만으로는 부족합니다.
포지션, 라벨, 범례, 시각적 관계를 추론할 수 있는 멀티모달 도구를 선택하세요.
3. 한 장인가요, 수천 장인가요?
가끔 수동으로 분석한다면 사용자에게 직접 제공되는 요약 도구가 더 간단합니다.
수천~수백만 장의 이미지라면 Google Cloud Vision, Azure AI Vision, Amazon Rekognition 같은 API가 더 적합합니다.
4. 요약 이후 무엇이 필요하나요?
후속 질문을 하고 싶거나, 이미지를 비교하고, 노트를 만들거나, 결과를 다른 문서로 바꾸고 싶다면 대화형 워크플로가 있는 도구를 선택하세요.
소프트웨어 시스템에 필요한 구조화된 라벨만 원한다면 API만으로도 충분할 수 있습니다.
더 나은 사진 요약을 위한 프롬프트 예시
대시보드용:
대시보드를 다섯 가지 핵심으로 요약해줘. 보이는 날짜 범위와 정확한 지표 값을 유지해줘. 관찰 내용과 가능한 설명을 분리해줘.
스캔 페이지용:
텍스트를 추출한 다음, 핵심 주장(메인 아규먼트)을 요약해줘. 고유명사, 날짜, 인용문은 변경하지 마. 추측하지 말고 읽기 어려운 텍스트는 표시해줘.
차트용:
축, 그룹, 추세, 최고/최저 값, 그리고 보이는 이상 징후(애노말리)를 설명해줘. 상관관계로부터 인과관계를 추론하지 마.
스크린샷 여러 장 세트용:
각 스크린샷을 먼저 개별로 요약해줘. 그다음 반복되는 문제, 차이점, 그리고 모든 이미지에서 가장 중요한 결론 세 가지를 식별해줘.
구체적인 프롬프트는 도구가 시각적으로는 눈에 띄지만 중요하지 않은 디테일에 집중할 가능성을 줄여줍니다.
프라이버시가 중요합니다
이미지를 업로드하기 전에, 이미지에 무엇이 더 포함되어 있는지 확인하세요.
스크린샷에는 이름, 이메일 주소, 내부 대시보드, 고객 정보, 계정 번호, 또는 개인 메시지가 노출될 수 있습니다.
업무에 필요하지 않은 정보는 크롭하거나 가리고, 기밀 이미지에 대해서는 조직에서 승인한 데이터 처리 정책을 따르세요.
가장 좋은 AI 사진 요약 도구는 ‘작업’에 따라 달라집니다.
읽을 수 있는 설명과 후속 분석이 필요하다면 iWeaver, ChatGPT, Gemini를 선택하세요. “사진”이 실제로는 스캔 문서라면 Adobe를 사용하세요. 소프트웨어에 이미지 이해를 구축한다면 Google Cloud Vision, Azure AI Vision, Amazon Rekognition을 선택하세요.
핵심 구분은 간단합니다. OCR은 텍스트를 추출하고, 컴퓨터 비전은 시각적 요소를 감지하며, 멀티모달 요약은 그 신호를 의미로 바꿉니다.