
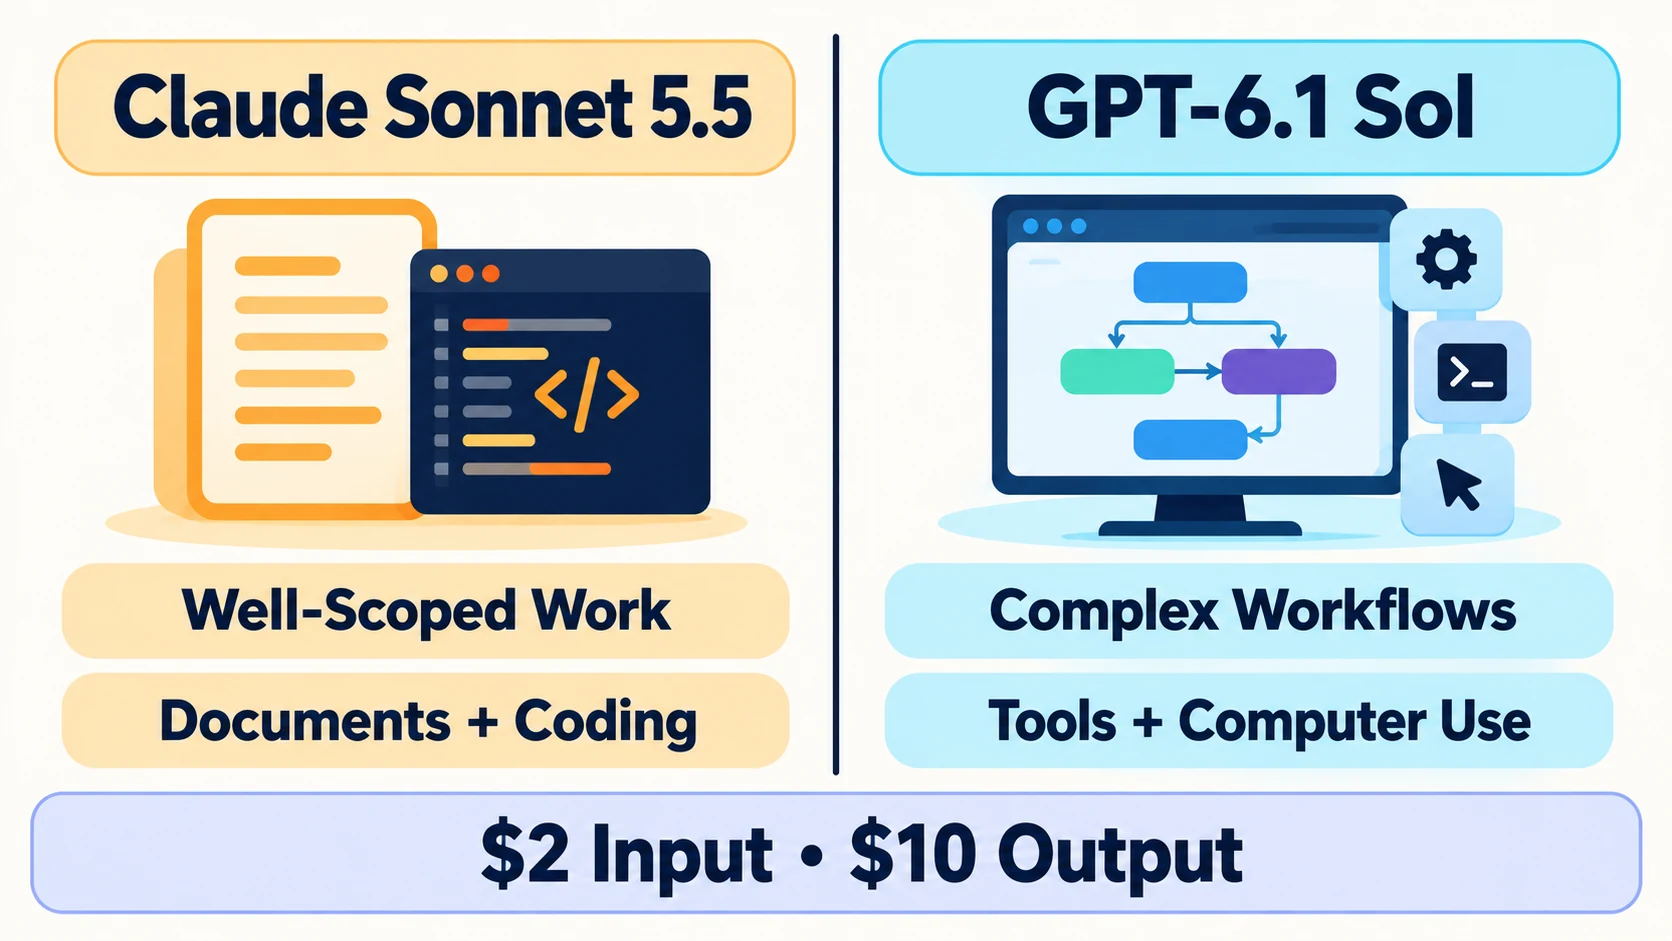
Claude Sonnet 5.5와 GPT-6.1 Sol은 표준 API 토큰 가격이 동일하지만, 서로 다른 강점을 바탕으로 설계되었습니다. Sonnet 5.5는 빠르고 범위가 명확한 코딩 및 전문적인 작업에 적합한 포지션입니다. GPT-6.1 Sol은 복잡한 코딩, 컴퓨터 사용, 도구 기반 작업, 그리고 전문적인 워크플로우를 대상으로 하면서도, 더 낮은 비용으로 Astra에 준하는 성능을 제공합니다.
실제 선택은 작업에 따라 달라집니다. Sonnet 5.5는 범위가 정해진 코딩, 완성도 높은 문서, 슬라이드, 스프레드시트에 대해 체험해 볼 가치가 있습니다. GPT-6.1 Sol은 매우 큰 컨텍스트 윈도우, OpenAI의 Responses API 도구, 혹은 멀티 스텝 워크플로우가 필요할 때 강력한 후보입니다. iWeaver는 GPT-6.1 Sol 무료 체험을 제공하므로, 모델을 직접 문서와 연구 과제에 적용해 본 뒤 선택할 수 있습니다.
Claude Sonnet 5.5 vs GPT-6.1 Sol 한눈에 보기
| 항목 | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| 표준 입력 가격 | 1M 토큰당 $2 | 1M 토큰당 $2 |
| 표준 출력 가격 | 1M 토큰당 $10 | 1M 토큰당 $10 |
| 캐시 읽기 가격 | 1M 토큰당 $0.20 | 1M 토큰당 $0.10 |
| 컨텍스트 윈도우 | 선택한 Claude 플랫폼 확인 | 1,050,000 토큰 |
| 최대 출력 | 선택한 Claude 플랫폼 확인 | 128,000 토큰 |
| 명시된 집중 분야 | 범위가 명확한 코딩과 전문 작업 | 복잡한 코딩, 컴퓨터 사용, 전문 업무 |
| 추론 제어 | 조절 가능한 노력(effort) | 낮음, 중간, 높음, xhigh, max |
| API 모델명 | claude-sonnet-5-5 |
gpt-6.1-sol |
GPT-6.1 Sol 수치는 OpenAI의 모델 문서에서 가져왔습니다. Sonnet 5.5의 가격과 포지셔닝은 Anthropic의 출시 발표에서 확인했습니다. 롱컨텍스트 가격, 배치 처리, 패스트 모드, 캐시 쓰기, 툴 호출, 클라우드 제공업체 조건에 따라 최종 비용은 달라질 수 있습니다.
코딩: 원시 역량만큼 ‘범위 제어’가 중요하다
Anthropic은 Sonnet 5.5를 일상적인 전문 작업, 버그 수정, 그리고 범위가 명확하게 정리된 작업을 위한 빠른 모델로 포지셔닝합니다. 공개 자료에서는 Terminal-Bench 4.0에서 70.6%, FrontierCode 1.1 Main에서 Max effort로 46.2%를 포함해 강력한 코딩 성과를 보고합니다.
GPT-6.1 Sol은 복잡한 코딩과 에이전트(대행)형 작업을 위해 설계되었습니다. OpenAI는 Responses API를 통해 코드 실행, 호스팅된 셸, 패치 적용, 컴퓨터 사용 등 다양한 도구에 접근할 수 있도록 지원합니다.
하지만 이런 사실만으로 보편적인 ‘승자’를 단정할 수는 없습니다. 코딩 평가는 동일한 리포지토리 이슈, 지침, 환경, 시간 예산을 기준으로 진행해야 합니다. 모델이 올바른 원인을 찾아냈는지, 필요한 파일만 변경했는지, 적절한 점검을 실행했는지, 그리고 작업이 완료되면 멈췄는지 확인해 보세요.
작업의 범위가 정해져 있고 빠른 반복이 중요한 경우에는 체험으로 Sonnet 5.5를 선택하세요. 더 넓은 리포지토리 컨텍스트, 도구 조율, 그리고 구현 및 검증 단계가 여러 번 필요한 경우에는 체험으로 GPT-6.1 Sol을 선택하는 편이 좋습니다.
문서 및 지식 작업
Sonnet 5.5는 완성도 높은 문서, 슬라이드, 스프레드시트를 만드는 데 ‘명시적으로’ 적합한 포지션입니다. Anthropic의 공개 근거 역시 Sonnet 5에 비해 전문 지식 작업과 효율이 개선되었음을 강조합니다.
GPT-6.1 Sol은 문서용으로 1,050,000 토큰 컨텍스트 윈도우를 문서화해 제공하며, 최대 128,000 토큰 출력까지 지원합니다. 그래서 대규모 문서 세트, 리서치 종합, 정책 검토, 그리고 상세한 구조화 산출물에 특히 흥미로운 선택지가 됩니다.
컨텍스트 용량만으로 문서 품질을 입증할 수는 없습니다. 동일한 소스 패킷으로 두 모델을 모두 테스트하고, 수치를 추출하고, 충돌하는 문장을 조정하며, 근거와 추론을 구분하고, 각 결론이 어디에서 나왔는지 보여 달라고 요청해 보세요. 더 ‘검증 가능한’ 결과를 만드는 모델이, 더 매끄러운 첫 초안을 쓰는 모델보다 더 가치 있을 수 있습니다.
도구와 워크플로우 적합성
GPT-6.1 Sol의 가장 명확한 장점은 Responses API를 통한 ‘문서화된’ 도구 표면(tool surface)입니다. 웹 검색, 파일 검색, 이미지 생성, 코드 실행, 호스팅된 셸, 컴퓨터 사용, MCP, 그리고 도구 검색을 지원합니다. 이는 이미 OpenAI의 에이전트 스택 위에서 구축 중인 팀의 통합 마찰을 줄여줄 수 있습니다.
Sonnet 5.5는 Claude 제품, Claude Platform, AWS, Google Cloud, Microsoft Azure에서 사용할 수 있습니다. 조직이 이미 그 환경을 사용 중이거나, Claude에 맞춰 프롬프트와 평가를 튜닝해 두었다면 더 자연스럽게 들어맞을 가능성이 큽니다.
모델을 둘러싼 플랫폼도 중요합니다. 로깅, 권한, 소스 관리, 검토 단계, 데이터 요구 사항, 팀 워크플로우는 벤치마크에서의 작은 차이를 능가할 수 있습니다.
더 이른 기준(베이스라인)을 보고 싶은 분들은 6.1 업데이트가 무엇을 바꾸는지 평가하기 전에 iWeaver가 게시한 Claude Sonnet 5.5 vs GPT-6 비교를 먼저 확인해 보세요.
비용: 토큰 가격은 같지만, 작업 비용은 다르다
두 모델 모두 입력 토큰 1M당 $2, 출력 토큰 1M당 $10의 표준 가격을 제시합니다. 하지만 이는 과제가 완료되는 데 드는 비용이 같다는 뜻은 아닙니다.
총 작업 비용에는 프롬프트 크기, 캐시 동작, 추론 노력, 도구 호출, 재시도 횟수, 출력 길이, 그리고 사람이 하는 검토 시간이 포함됩니다. Anthropic은 Sonnet 5.5가 Sonnet 5보다 더 적은 토큰으로 사용되고 더 빠르게 실행될 수 있다고 말하지만, 이는 선행 모델 대비 비교이지 GPT-6.1 Sol보다 저렴하다는 증거는 아닙니다.
수용 가능한 결과에 도달하는 ‘총 비용’을 측정하세요. 개별 응답이 더 길더라도 수정이 더 적게 드는 모델이라면 결과적으로 더 저렴할 수 있습니다.
어떤 모델을 선택해야 할까?
우선순위가 범위가 잘 정리된 코딩, 빠른 반복, 그리고 문서 및 오피스 스타일 출력물의 완성도라면 Claude Sonnet 5.5를 사용해 보세요. 가장 강력한 공개 근거와 제품 포지셔닝이 바로 이런 작업과 맞닿아 있습니다.
컨텍스트 윈도우가 크거나, OpenAI 도구 생태계가 필요하거나, 복잡한 멀티 스텝 작업을 해야 하거나, Astra보다 더 낮은 비용 대안을 찾고 있다면 GPT-6.1 Sol을 사용해 보세요. 또한 사용 중인 애플리케이션이 이미 Responses API에 의존하고 있다면 더 자연스러운 선택이 될 것입니다.
공정한 결정을 위해 하나의 일반적인 프롬프트보다 세 가지 대표 작업을 실행해 보세요. (일상적인 작업, 어려운 작업, 소스가 많이 필요한 작업) 정답성, 완결성, 지연 시간, 총 토큰 수, 불필요한 변경, 그리고 검토 시간까지 점수를 매겨 보세요.
iWeaver에서 GPT-6.1 Sol 무료 체험을 시작하고, 본인 문서나 리서치 워크플로우로 직접 평가해 보실 수 있습니다. 가장 좋은 모델은 가장 적은 총 노력으로 품질 기준을 충족하는 모델입니다. 가장 요란한 헤드라인을 가진 모델이 아닙니다.