
GPT-6.1 Sol은 OpenAI의 GPT-6 제품군에서 업데이트된 균형형(balanced) 모델입니다. GPT-6 Sol과 동일하게 큰 컨텍스트 윈도우, 최대 출력 크기, 표준 $2/$10 입력-출력 가격대를 유지하지만, OpenAI는 이제 6.1을 더 낮은 비용으로 복잡한 작업에서 ‘Astra에 준하는 성능’을 제공하는 모델로 포지셔닝하고 있습니다.
이번 업데이트는 중요한 설정 디테일도 바꿉니다. GPT-6.1 Sol은 low부터 max까지 추론 노력(reasoning effort)을 지원하지만, 더 이상 none 또는 minimal은 지원하지 않습니다. 개발자와 파워 유저는 이전 설정을 그대로 복사할 수 있다고 가정하기보다, 모델을 업그레이드로 평가해 보아야 합니다.
iWeaver는 GPT-6.1 Sol 무료 체험을 제공합니다. 업데이트된 모델의 결과와 워크플로를 여러분이 이미 알고 있는 방식과 손쉽게 비교할 수 있습니다.
GPT-6.1 Sol vs GPT-6 Sol 한눈에 보기
| 항목 | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| 포지셔닝 | 복잡한 코딩 및 에이전트형 워크플로 | 더 낮은 비용으로 복잡한 작업에 ‘Astra에 준하는 성능’ |
| 표준 입력 가격 | 1M 토큰당 $2 | 1M 토큰당 $2 |
| 표준 출력 가격 | 1M 토큰당 $10 | 1M 토큰당 $10 |
| 컨텍스트 윈도우 | 1,050,000 토큰 | 1,050,000 토큰 |
| 최대 출력 | 128,000 토큰 | 128,000 토큰 |
| 추론 노력 | None, low, medium, high, xhigh, max | Low, medium, high, xhigh, max |
| 도구 호출 | Responses API 권장 | 도구 호출에는 Responses API 필요 |
| API 모델 ID | gpt-6-sol |
gpt-6.1-sol |
이 비교는 OpenAI의 GPT-6.1 Sol 문서, 현재 모델 카탈로그, GPT-6 가이드를 기반으로 합니다. 가격은 긴 컨텍스트, 캐싱, 서비스 티어, 지역별 처리, 도구 사용에 따라 달라질 수 있습니다.
핵심 변화는 ‘역량 포지셔닝’
GPT-6 Sol은 GPT-6 제품군의 균형형(balanced) 멤버로 출시되었으며, 복잡한 코딩과 에이전트형 워크플로를 목표로 했습니다. GPT-6.1 Sol은 더 야심 찬 설명을 받습니다. 즉, 더 낮은 비용으로 복잡한 코딩, 컴퓨터 사용, 그리고 전문적인 작업에서 ‘Astra에 준하는 성능’을 제공한다는 내용입니다.
기존 제품군 포지셔닝은 iWeaver의 GPT-6 Astra vs Sol vs Luna 비교를 참고하세요. 이는 업데이트된 Sol 모델이 지금 어디쯤에 위치하는지 이해하기 위한 기준점입니다.
그렇다고 모든 6.1 응답이 Astra와 같거나, 모든 GPT-6 Sol 작업을 일괄적으로 개선한다는 뜻은 아닙니다. 다만 Sol이 품질-비용 곡선에서 OpenAI 상위 티어에 더 가까운 위치로 포지셔닝되고 있다는 의미입니다. 팀은 특히 판단(judgment), 긴 소스 자료, 도구, 그리고 여러 단계에 걸친 의존 작업이 포함된 태스크에서, 그 주장을 자체 평가 세트로 검증해야 합니다.
컨텍스트와 출력 한도는 크게 유지
두 모델 모두 1,050,000 토큰 컨텍스트 윈도우와 최대 출력 128,000 토큰을 목록으로 제공합니다. 따라서 이미 큰 입력에 의존하는 애플리케이션은 더 작은 컨텍스트 용량을 기준으로 재설계할 필요가 없습니다.
이 한도는 모든 요청을 꽉 채우라는 권장 사항이 아닙니다. 272,000 토큰을 초과하는 입력은 문서에 명시된 GPT-6.1 Sol 요율에 따라 더 높은 장기(long-context) 가격이 적용됩니다. 또한 큰 프롬프트는 어떤 자료가 관련 있는지 파악하기 더 어려워질 수도 있습니다. 전체 컬렉션이 들어맞는 경우에도 검색(retrieval), 소스 라벨링(source labeling), 단계적 분석(staged analysis)은 여전히 유용합니다.
추론 설정은 주의가 필요
GPT-6 Sol은 none을 지원하지만 GPT-6.1 Sol은 지원하지 않습니다. 업데이트된 모델은 low, medium, high, xhigh, max를 지원하며, medium이 문서에 명시된 기본값입니다.
기존 워크플로가 none 또는 minimal을 사용한다면, OpenAI는 6.1로 이동할 때 low부터 시작한 뒤 대표 태스크에서 출력이 어떻게 달라지는지 비교하라고 권장합니다. 더 높은 노력은 어려운 추론을 개선할 수 있지만, 지연(latency)과 토큰 사용량이 증가할 수 있습니다. 효과를 측정하기 전에는 기본값으로 설정을 올리지 마세요.
도구 사용은 Responses API에 해당
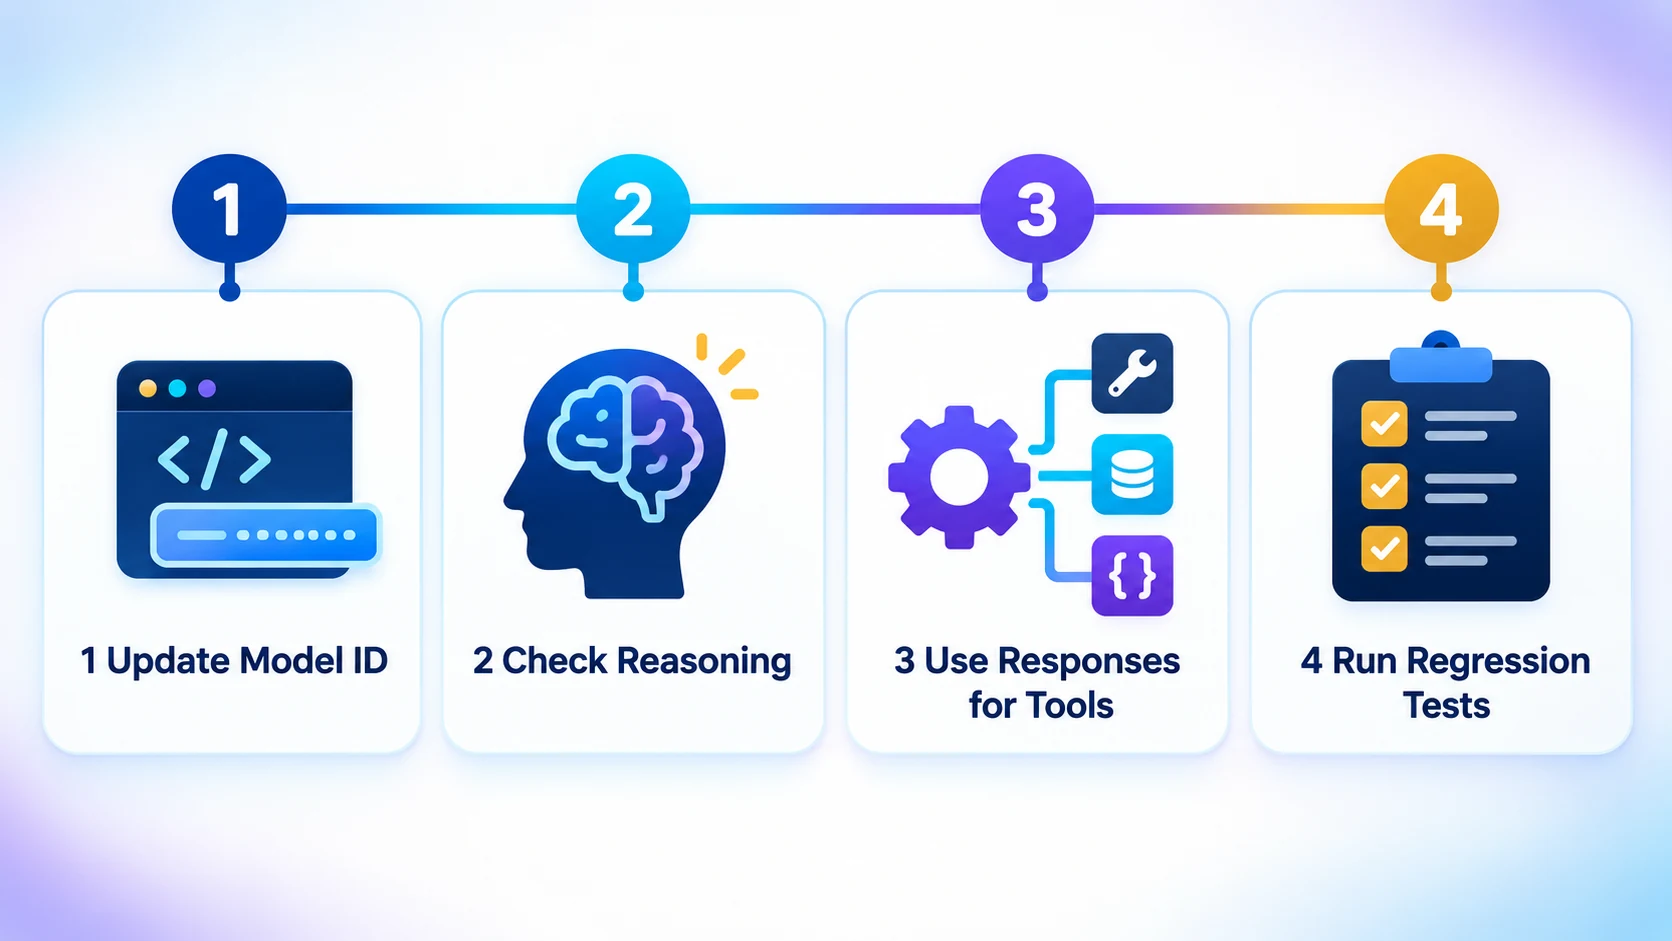
GPT-6.1 Sol은 도구가 없는 요청에 대해 Chat Completions을 지원합니다. 도구 호출(tool calling)의 경우 Responses API를 사용하세요. 지원되는 도구 세트에는 웹 검색, 파일 검색, 이미지 생성, 코드 실행, 호스팅된 셸, 패치 적용(apply patch), 컴퓨터 사용(computer use), MCP, 도구 검색(tool search)이 포함됩니다.
이는 에이전트 애플리케이션에서 중요합니다. 모델 업그레이드는 단순히 모델 ID만 바꾸는 일이 아닙니다. 엔드포인트, 지원되지 않는 파라미터, 추론 설정, 캐싱 동작, 도구 정의, 평가 결과를 점검해야 할 수도 있습니다.
업그레이드해야 할까요?
GPT-6.1 Sol은 GPT-6 Sol을 코딩, 컴퓨터 사용, 리서치, 문서 생성 또는 기타 복잡한 전문 작업에 활용한다면 평가해볼 만합니다. 업그레이드의 가장 강력한 이유는 동일한 표준 입력/출력 토큰 가격에서 더 나은 완료 품질(completion quality) 가능성이 있기 때문입니다.
프로덕션 워크플로가 none 추론에 의존하거나, 회귀 테스트를 완료하지 않았거나, 이미 검증된 안정적인 동작이 필요한 경우에는 GPT-6 Sol을 일시적으로 유지하세요. 두 모델을 동일한 입력과 수용 기준(acceptance criteria)으로 비교한 뒤 업그레이드하세요.
간단한 마이그레이션 테스트
애플리케이션이 실제로 수행하는 작업을 대표하는 10–20개 태스크를 선택하세요. 일반적인 케이스, 어려운 케이스, 긴 컨텍스트 케이스, 그리고 알려진 실패 케이스를 포함하세요. 두 모델을 동일한 지시로 실행하고 다음을 기록하세요.
- 정확성 및 태스크 완료 여부.
- 지시 준수 및 범위 제어.
- 도구 호출 성공 여부.
- 지연 시간과 총 토큰 사용량.
- 사람의 검토 및 수정 시간.
‘none’, minimal, 샘플링 파라미터(sampling parameters), 도구 호출, 프롬프트 캐싱(prompt caching)을 사용 중인 부분이 있는지 확인한 뒤에만 모델 ID를 변경하세요. OpenAI의 마이그레이션 가이드는 추론이 활성화되면 일부 파라미터가 지원되지 않을 수 있음을 언급합니다.
빠르게 직접 평가해보고 싶다면 iWeaver에서 GPT-6.1 Sol 무료 체험을 시작하고, 익숙한 리서치/문서/작성 태스크를 다시 실행해 보세요. 동일한 품질 체크리스트로 이전 Sol 출력과 결과를 비교하세요. 그러면 단지 ‘출시 라벨’에 의존하지 않고, 업그레이드 결정을 실제로 구체화할 수 있습니다.