
Claude Opus 5.5 と OpenAI の GPT-6 ファミリーは、いま多くの同じように要求の高い AI ワークロードをめぐって競合していますが、アプローチは異なります。
Anthropic は Claude Opus 5.5 を、長期稼働のエージェント型コーディングやプロフェッショナルな知識業務のためのものとして位置づけています。OpenAI は GPT-6 を 3 つのモデルに分けており、Astra は最も難しいエンドツーエンドのタスク、Sol は複雑なコーディングとエージェント、そして Luna は集中型で高ボリュームのワークロードに向けています。
そのため、役立つ比較はもはや「Claude vs GPT」だけではありません。
それは、
Claude Opus 5.5 vs GPT-6 Astra、Sol、Luna――実際のあなたのワークロードに合うのはどのモデル?
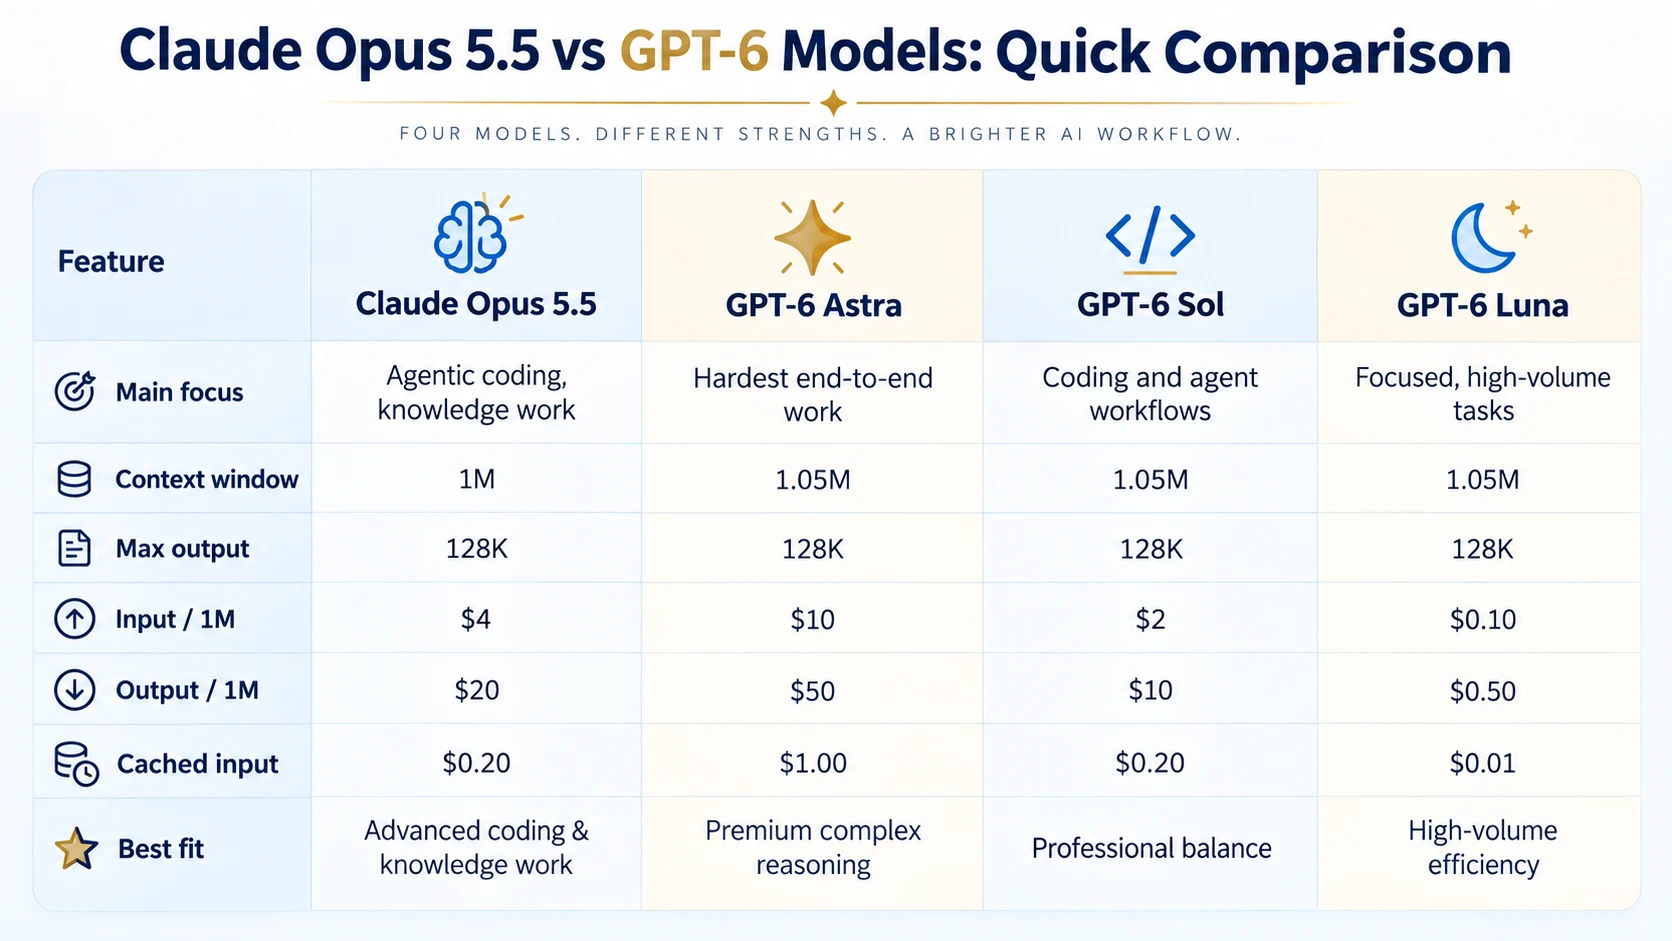
Claude Opus 5.5 vs GPT-6:ひと目で比較
| 機能 | Claude Opus 5.5 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| 主な用途 | エージェント型コーディング、知識業務 | 最も難しいエンドツーエンド作業 | コーディングとエージェントのワークフロー | 集中型・高ボリュームのタスク |
| コンテキストウィンドウ | 1M | 1.05M | 1.05M | 1.05M |
| 最大出力 | 128K | 128K | 128K | 128K |
| 入力 / 1M | $4 | $10 | $2 | $0.10 |
| 出力 / 1M | $20 | $50 | $10 | $0.50 |
| キャッシュ入力 | $0.20 | $1.00 | $0.20 | $0.01 |
| 知識のカットオフ | 2026年6月 | 2026年4月30日 | 2026年4月20日 | 2026年5月18日 |
Claude Opus 5.5 は 1M トークンのコンテキストウィンドウと 128K の標準出力に対応しています。一方で、3 つの GPT-6 モデルはいずれも、同じ 128K の最大出力を保ちながら、少し大きい 1.05M のコンテキストウィンドウを提供します。
Claude Opus 5.5 vs GPT-6 Astra
GPT-6 Astra は、難しい推論、コーディング、リサーチ、あるいは長期稼働のエージェントが絡むタスクにおいて、Claude Opus 5.5 と最も直接的に比較しやすい選択肢です。
OpenAI は Astra を、複雑な推論、コーディング、コンピューター操作、リサーチ、ドキュメント作成を含む、最も難しいエンドツーエンド作業向けとして自社の最も能力の高いモデルだと説明しています。Anthropic は Opus 5.5 を、長期稼働のエージェント型コーディングや知識業務向けのモデルとして位置づけています。
最大の実務上の違いは、価格です。
Claude Opus 5.5 の料金:
- $4 / 1M 入力トークン
- $20 / 1M 出力トークン
GPT-6 Astra の料金:
- $10 / 1M 入力トークン
- $50 / 1M 出力トークン
標準的な掲載レートで見ると、したがって Opus 5.5 は Astra よりも入力・出力トークンあたりで 60% 低コストです。
Astra はコンテキストウィンドウがわずかに大きい――1.05M 対 1M――ものの、この差は価格差に比べると比較的小さいです。
ベンチマークは何を示している?
Anthropic が公開している Opus 5.5 の結果には、GPT-6 Astra との直接比較が含まれています。
Anthropic のテストでは、Opus 5.5 は Terminal-Bench 4.0 や FrontierCode v1.1 などのベンチマークで GPT-6 Astra より高いスコアでした。一方で GPT-6 Astra は AutomationBench や Terminal-Bench-Science 0.1 のようなテストで上回っています。また Anthropic は、ベンチマークの差は注意深く解釈すべきだとも述べています。というのも、テスト条件や統計的不確実性は異なるためです。
そのため、比較を単一の総合スコアに落とし込むのは難しくなります。
実際のワークフローでは、多くの場合「そのモデルが、コーディング/リサーチ/エージェント作業を確実に完了できるか」と「完了にかかるコストがどれくらいか」が、より良い判断材料になります。
Claude Opus 5.5 vs GPT-6 Sol
GPT-6 Sol は、Opus 5.5 よりも多くのプロフェッショナルユーザーにとって「より面白い」代替になる可能性があります。
両モデルとも、明確に コーディングとエージェント型のワークフロー を中心に位置づけています。
ただし、価格は異なります:
| モデル | 入力 / 1M | 出力 / 1M |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Sol | $2 | $10 |
GPT-6 Sol は標準的な入力・出力トークンあたりで、Opus 5.5 の半額のコストです。
さらに、Opus 5.5 の 1M に対して 1.05M のコンテキストウィンドウを提供します。どちらも最大 128K の出力トークンに対応しています。
そのため Sol は、たとえば次のような頻繁なワークロードに検討する価値があります:
- 毎日のコーディング
- コードレビュー
- AI エージェント
- ツールベースのワークフロー
- リサーチ
- ドキュメント分析
- ビジネス自動化
Opus 5.5 は、Anthropic の Opus クラスの推論と、長期稼働のエージェント型タスクに強くフォーカスしている点から、より魅力が増します。一方で Sol は、反復的なコーディングやエージェント作業に対してコスト意識の高い選択肢として位置づけられています。
Claude Opus 5.5 vs GPT-6 Luna
Claude Opus 5.5 と GPT-6 Luna は、非常に異なるワークロードを狙っています。
Luna は OpenAI の GPT-6 の中で、集中型かつ高ボリュームのタスクに最も効率的なモデルです。API の料金は次の通りです:
- $0.10 / 1M 入力トークン
- $0.50 / 1M 出力トークン
これは Opus 5.5 の $4 / $20 から見ると、はるかに低価格です。
Luna は次のようなタスクにより理にかなっています:
- 分類
- 情報抽出
- 書式設定
- 短い要約
- コンテンツ処理
- 繰り返しの自動化
Opus 5.5 は、ワークロードの反対側を狙っています。つまり、複雑なコーディング、より深い知識業務、そして多くのステップにわたって推論を継続する必要があるかもしれないタスクです。
そのため、これは単なる「モデル対モデル」の直接対決というより、そもそもそのタスクに高度な推論モデルが必要かどうかを判断する話になります。
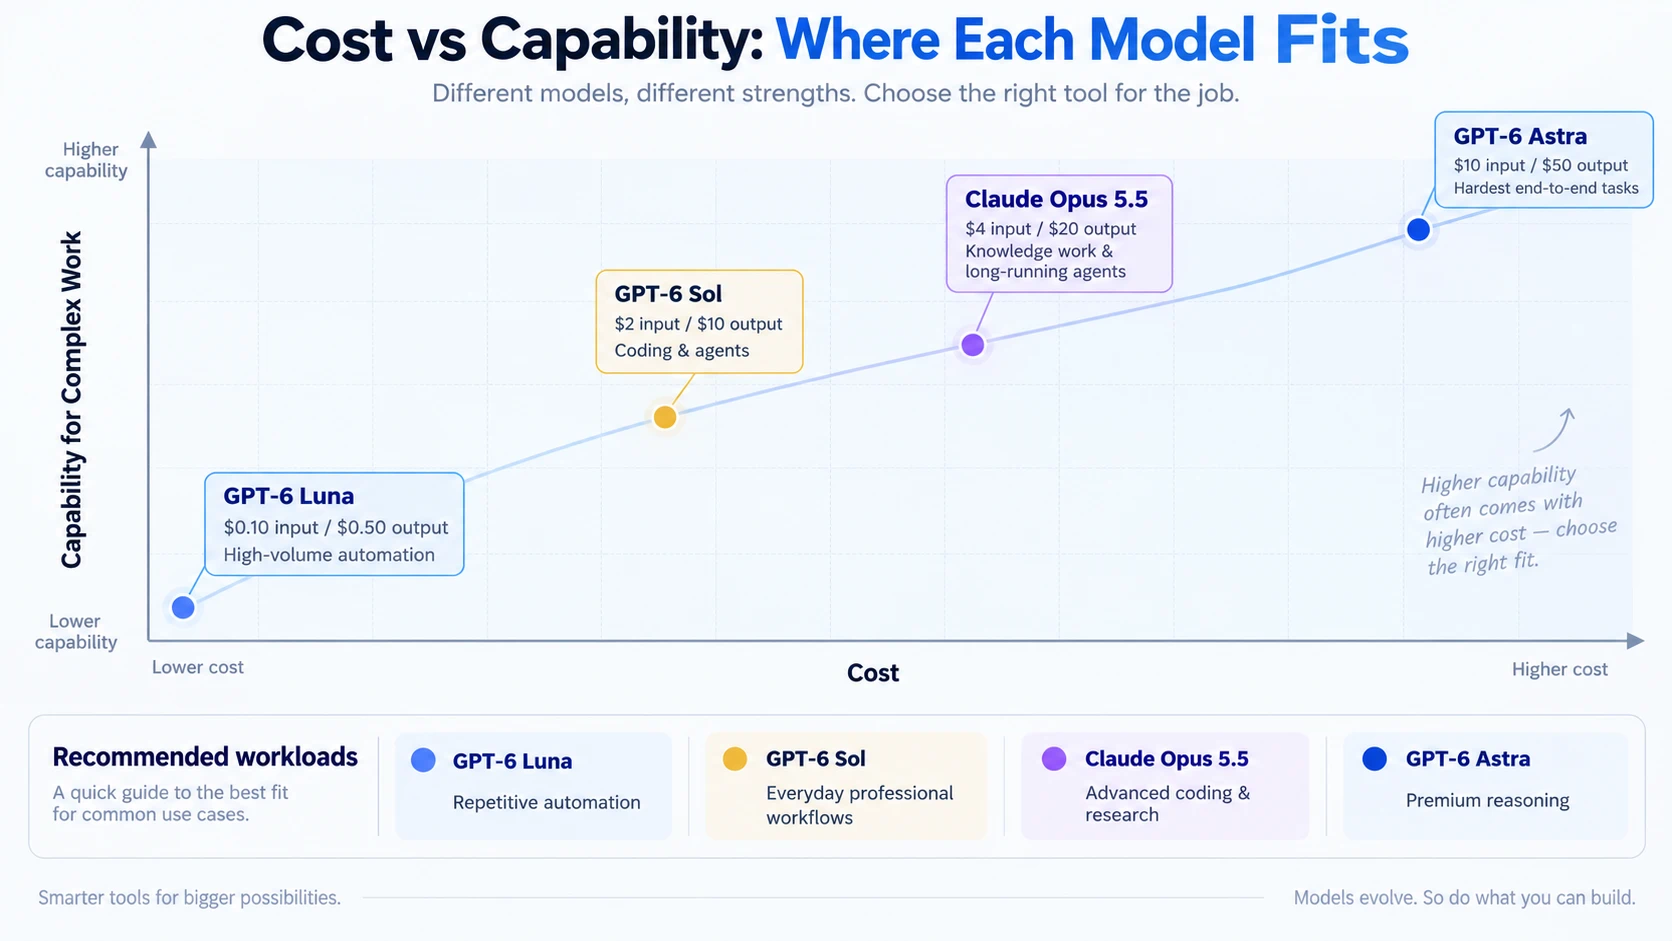
料金:各モデルがハマる場所
価格の段階(ラダー)を見ると、位置づけが特に明確になります。
| モデル | 入力 | 出力 | 相対的な位置づけ |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 | 高ボリューム効率 |
| GPT-6 Sol | $2 | $10 | プロ向けのバランス |
| Claude Opus 5.5 | $4 | $20 | 高度なコーディング & 知識業務 |
| GPT-6 Astra | $10 | $50 | プレミアムなエンドツーエンド推論 |
これらは標準的に掲載されているトークン価格です。OpenAI は、入力トークンが 272K を超える GPT-6 リクエストに対してより高い価格を適用するため、非常に長いコンテキストのワークロードではコスト計算が変わり得ます。
また Anthropic も、Opus 5.5 で 1,000,000 キャッシュ読み取りトークンあたり $0.20 のプロンプトキャッシュに対応しています。大きなコンテキストを繰り返し再利用するエージェントでは、これが重要になる場合があります。
どのモデルが、どのタスクに合う?
4 つのモデルを比較する実践的な方法は、ブランドではなく「ワークロード」で考えることです。
| タスク | テストする価値があるモデル |
|---|---|
| 難しいエンドツーエンド推論 | Claude Opus 5.5 / GPT-6 Astra |
| 大規模なコーディングプロジェクト | Claude Opus 5.5 / GPT-6 Astra / Sol |
| 長期稼働のエージェント | Claude Opus 5.5 / GPT-6 Sol / Astra |
| 日常のプロ向けコーディング | GPT-6 Sol / Claude Opus 5.5 |
| リサーチと知識業務 | Claude Opus 5.5 / GPT-6 Astra / Sol |
| 高ボリュームの抽出 | GPT-6 Luna |
| 分類と書式設定 | GPT-6 Luna |
| 繰り返しの自動化 | GPT-6 Luna / Sol |
ワークフローのすべてのステップで同じモデルを使う必要はありません。
例えば、実運用のエージェントでは軽量な抽出に Luna を使い、通常の推論ステップには Sol を使い、特に難しいタスクは Astra や Opus 5.5 に振り分けることができます。
このような設計は、すべてを 1 つのモデルに任せるよりも、コスト面で効いてくることがあります。
iWeaver で Claude Opus 5.5 と GPT-6 シリーズを試す
仕様やベンチマークは参考になりますが、自分のドキュメント、プロンプト、ワークフローで「どのモデルがうまく機能するか」を必ずしも予測できるとは限りません。
iWeaver では Claude Opus 5.5 を GPT-6 シリーズ(GPT-6 Astra、Sol、Luna を含む)と並べて、別々の API 統合を構築することなく試せます。
iWeaver では 無料の毎日クレジット も提供されるため、同じ実タスクを異なるモデルでテストできます。たとえば:
- PDF の要約
- 複数のドキュメントの比較
- リサーチと分析
- ライティング
- 知識抽出
- コーディングの質問
同じタスクを複数のモデルで実行すると、ベンチマーク数字だけに頼るよりも、回答の深さ、速度、役立ちやすさを比較しやすくなります。
もし OpenAI のフラッグシップモデルから始めたい場合は、GPT-6 Astra を無料で使う方法のガイドをご覧ください。
Claude Opus 5.5 は、現在のフロンティアモデル市場の中で興味深いポジションにあります。
GPT-6 Astra よりも大幅に低コストでありながら、同等に要求の高いコーディング、エージェント、知識業務のユースケースを狙っています。GPT-6 Sol は価格面で Opus 5.5 を下回り、コーディングとエージェントに強くフォーカス。一方で GPT-6 Luna は、まったく別のニーズに応えます――スケールしたときの低コストな処理です。
したがって、重要な問いは単に 「Claude Opus 5.5 か GPT-6 か?」 ではありません。
あなたのタスクに、フラッグシップ級の推論が必要なのか、バランスの取れたプロ向け性能なのか、それとも高ボリューム効率なのか――その点です。
そのため、Opus 5.5、Astra、Sol、Luna で同じワークフローをテストすることは、ベンチマーク表だけから選ぶよりも多くの場合、より有益です。