
Grok 4.7 がついに公式に登場しました。 2026年9月21日 にリリースされた Grok 4.7 は、xAI のコーディング、エージェント的タスク、プロフェッショナルな知識業務のための最新フロンティアモデルです。
これは Grok 4.6 の単なる小さなアップデートではありません。xAI は Grok 4.7 が 新しく、より大きなベースモデル を採用していること、強化学習の実行時間がより長いこと、さらに完了までに数時間かかり得る難しいタスクへより多くの重みを置いた学習を行っていると説明しています。加えて、自身の自己検証とロングコンテキスト管理も改善されています。短いプロンプトに答えるだけよりも、実際のワークフローではこの2つの重要度がはるかに高いからです。さらに、Grok 4.7 に関する初期の憶測とは違い、比較できる公式仕様とベンチマーク結果がすでに揃っています。
Grok 4.7 リリース日
Grok 4.7 は公式にローンチされました。xAI API 経由で利用できます: grok-4.7
ローンチ時、xAI は Grok Build や Cursor を含む複数のコーディング/AI プラットフォームでもモデルを提供開始しました。GitHub もまた、GitHub Copilot ユーザーに向けて Grok 4.7 の提供を順次開始しています。
前世代についてのより詳しい背景は、こちらの Grok 4.6 レビュー もご覧ください。
Grok 4.7 仕様を一目で
以下が主要な公式仕様です。
| 仕様 | Grok 4.7 |
|---|---|
| リリース日 | 2026年9月21日 |
| モデル名 | grok-4.7 |
| コンテキストウィンドウ | 500,000 トークン |
| 知識の最終更新 | 2026年5月 |
| 入力モダリティ | テキストと画像 |
| 出力モダリティ | テキスト |
| テキスト出力上限 | 固定のテキスト出力上限なし |
| 推論レベル | Low, Medium, High, XHigh |
| デフォルト推論 | High |
| 関数呼び出し | 対応 |
| Web 検索 | 対応 |
| X 検索 | 対応 |
| コード実行 | 対応 |
| API サポート | Responses API、Chat Completions |
500K のコンテキストウィンドウ は、特に長いドキュメント、大規模コードベース、複数ファイルのプロジェクト、リサーチタスク、そして時間の経過とともに大量の情報を保持する必要があるエージェント的ワークフローに役立ちます。
Grok 4.7 は推論レベルを4段階にも対応しています:
- Low
- Medium
- High
- XHigh
これにより、開発者はタスクに応じてスピードと推論の深さを調整できます。
Grok 4.7 で何が新しくなった?
最も重要な変更は、派手な新しいインターフェース機能ではありません。
それは、モデルがより長く、より難しい作業をどう扱うかが改善されたことです。
1. 新しく、より大きなベースモデル
Grok 4.7 は、Grok 4.6 と比べて新しく、より大きなベースモデルを土台にしています。
これは重要です。Grok 4.6 に追加のポストトレーニングを施しただけではないからです。
ベースとなるモデルそのものが変わっています。
その後 xAI は、より難しいタスクの混合に対して、より長い強化学習を行い、完了までに何時間もかかり得る問題への比重を高めました。
狙いは明確です:
難しい作業を「うまく始める」だけでなく、「最後まで仕上げる」力を Grok に。
2. より良いロングタスク性能
多くのAIモデルは短いプロンプトでは見栄えが良い一方、タスクが長くなるほど信頼性が落ちがちです。
それは例えば次のような形で表れます:
- 指示の忘れ
- 判断の一貫性の欠如
- 繰り返し作業
- 依存関係の見落とし
- チェックされないままのエラー
- 早い段階のコンテキストの活用が不十分
Grok 4.7 は、より長く動作するタスクでの性能を特に高めるように学習されています。
これは、コーディングエージェント、リサーチのワークフロー、ドキュメント作成、そして複数段階を含むプロフェッショナルな業務にとりわけ重要です。
3. より良い自己検証
もう一つの重要な変更は、自己チェックの強化です。
単に答えを生成して終わりにするのではなく、Grok 4.7 は自身の作業をより慎重に検証するよう設計されています。
これは例えば次のようなタスクで大きく効いてきます:
- コードのデバッグ
- 大規模プロジェクトの編集
- 計算の確認
- ドキュメントのレビュー
- 長い指示の追従
- 複数のツールを順番に使う
もちろん、自己検証があるからといって、モデルが間違えないという意味ではありません。
リスクの高い作業では、人のレビューは引き続き重要です。
ただし、内部でのチェックがより良くなることで、長いワークフロー中に起こりがちな「明らかな失敗」を減らせる可能性があります。
4. エージェント型と知識業務のための強化
Grok 4.7 は、xAI の Grok Bot ハーネスをより深く理解できるようにも学習されました。
そのため、AI が単に1つの質問に答える以上のことを行う必要がある、エージェント型タスクで特に有用です。
たとえば:
- ファイルを調べる
- 情報を検索する
- コードを書く
- ツールを実行する
- 結果をレビューする
- 自分自身の作業を修正する
- より大きなタスクが完了するまで続ける
これは、より広い「フロンティアAI」へのシフトを反映しています。
重要な問いは、もはや単に次のことではありません:
モデルはこの質問に答えられるか?
むしろ今は、次のことです:
モデルはタスク全体をやり切れるか?
Grok 4.7 ベンチマーク
xAI は、Grok 4.7 を Grok 4.6 や他のフロンティアモデルと比較したベンチマーク結果を公開しました。
結果を見ると、とりわけコーディング、ターミナルベースのタスク、エンジニアリング、プロフェッショナルな知識業務で目立つ向上が見られます。
最もわかりやすく比較するために、以下の表では Grok 4.7 と Grok 4.6 の違い に焦点を当てています。
| ベンチマーク | Grok 4.7 | Grok 4.6 | 変化 |
|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | +5.9 pts |
| DeepSWE v1.1 | 71.0% | 65.2% | +5.8 pts |
| AA Briefcase v1.1 | 1,657 | 1,546 | +111 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | +17.7 pts |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | +3.8 pts |
| HealthBench Professional | 56.7% | 48.5% | +8.2 pts |
| EEBench | 64.0% | 53.0% | +11.0 pts |
このセットの中で最も大きな伸びは Terminal-Bench 4.0 のようです。Grok 4.7 は 38.0% で、Grok 4.6 の 20.3% と比べて大きく上回っています。
これは、ターミナルコマンド、ツール、リポジトリ、多段階の実行を含むエージェント型コーディングワークフローに特に関係が深いポイントです。
また Grok 4.7 は、電気工学、プロフェッショナルな知識業務、ソフトウェアエンジニアリング、そして臨床推論のベンチマークでも目立つ伸びを示しています。
Grok 4.7 vs Grok 4.6
ベンチマークの数値を見れば、世代間の変化がより分かりやすくなります。
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| Status | 前世代 | 最新世代 |
| Base model | 旧モデル | 新しく、より大きなベースモデル |
| Context window | — | 500K トークン |
| Long-running tasks | 強い | 改善 |
| Self-verification | 強い | 改善 |
| CursorBench 4.0 | 40.4% | 46.3% |
| DeepSWE v1.1 | 65.2% | 71.0% |
| Terminal-Bench 4.0 | 20.3% | 38.0% |
| EEBench | 53.0% | 64.0% |
| API input price | $2 / 1M tokens | $2 / 1M tokens から |
| API output price | $6 / 1M tokens | $6 / 1M tokens から |
したがって、Grok 4.6 から Grok 4.7 へ移る最大の理由は、単一の目玉機能ではありません。
その理由は、次の組み合わせです:
より良いコーディング + より強いロングタスク性能 + より良いコンテキスト管理 + より強い自己チェック。
もしあなたの業務が主に短い日常的な質問で構成されているなら、違いは小さく感じられるかもしれません。
しかし、長く複数段階のワークフローを実行する開発者やユーザーにとっては、この改善はより意味のあるものになります。
Grok 4.7 の料金
Grok 4.7 の料金は以下からです:
- 入力 100万トークンあたり $2
- キャッシュ済み入力 100万トークンあたり $0.50
- 出力 100万トークンあたり $6
これらのレートは、プロンプトが 200K トークン未満の場合に適用されます。
200K トークンを超えるプロンプトの場合、公式の API 料金は次のように増加します:
- 入力 100万トークンあたり $4
- キャッシュ済み入力 100万トークンあたり $1
- 出力 100万トークンあたり $12
この段階制の料金体系は注目に値します。なぜなら Grok 4.7 のコンテキストウィンドウは 500K だからです。
そのため、コンテキストウィンドウを最大限使うと、短いリクエストよりもコストが高くなる可能性があります。
Grok 4.7 Fast とは?
xAI は Grok 4.7 Fast も提供しています。
これは、より高速なインフラで提供される同一の基盤モデルです。
xAI によれば、標準のトークンレートの2倍で、出力速度は約2倍になるとのことです。
ただし、重要な提供可用性の違いがあります:
Grok 4.7 Fast は現在 Cursor と Grok Build から利用できますが、一般公開されている xAI API では利用できません。
そのため、xAI API を直接使って開発する開発者にとっては、通常の Grok 4.7 モデルが主な選択肢になります。
Grok 4.7 はどこで使えますか?
Grok 4.7 は、すでに複数のプラットフォームで利用可能です。
xAI API
開発者は以下を利用できます:
grok-4.7
xAI の Responses API または Chat Completions API 経由で。
対応するツールには以下が含まれます:
- 関数呼び出し
- Web 検索
- X 検索
- コード実行
Grok Build
Grok 4.7 は Grok Build(xAI のコーディング/アプリ構築エージェント)のデフォルトモデルです。
Cursor
Grok 4.7 は Cursor で利用可能です。
Fast バリアントもそこで利用できます。
モデルゲートウェイ
xAI のドキュメントには、以下を含むプラットフォームでの提供が記載されています:
- OpenRouter
- Vercel
- Cloudflare
GitHub Copilot
GitHub は 9月21日から GitHub Copilot に Grok 4.7 の提供を開始しました。
Copilot Pro、Pro+、Max、Business、Enterprise の各プランで利用できるようにされています。
対応環境には以下が含まれます:
- Visual Studio Code
- Visual Studio
- Copilot CLI
- GitHub Copilot cloud agent
- GitHub Copilot app
- JetBrains
- Xcode
- Eclipse
提供は段階的に進むため、一部のユーザーにはすぐに見えない場合があります。
Grok 4.7 は「1つのベンチマーク」で判断しないで
公式結果は参考になりますが、ベンチマーク表だけを最終的なモデル選定の理由にすべきではありません。
ベンチマークはそれぞれ異なることをテストしています。
コーディングベンチマークで良い結果を出すモデルが、必ずしも次の用途で最適とは限りません:
- リサーチ
- ドキュメント分析
- 執筆
- カスタマーサポート
- データ抽出
- 要約
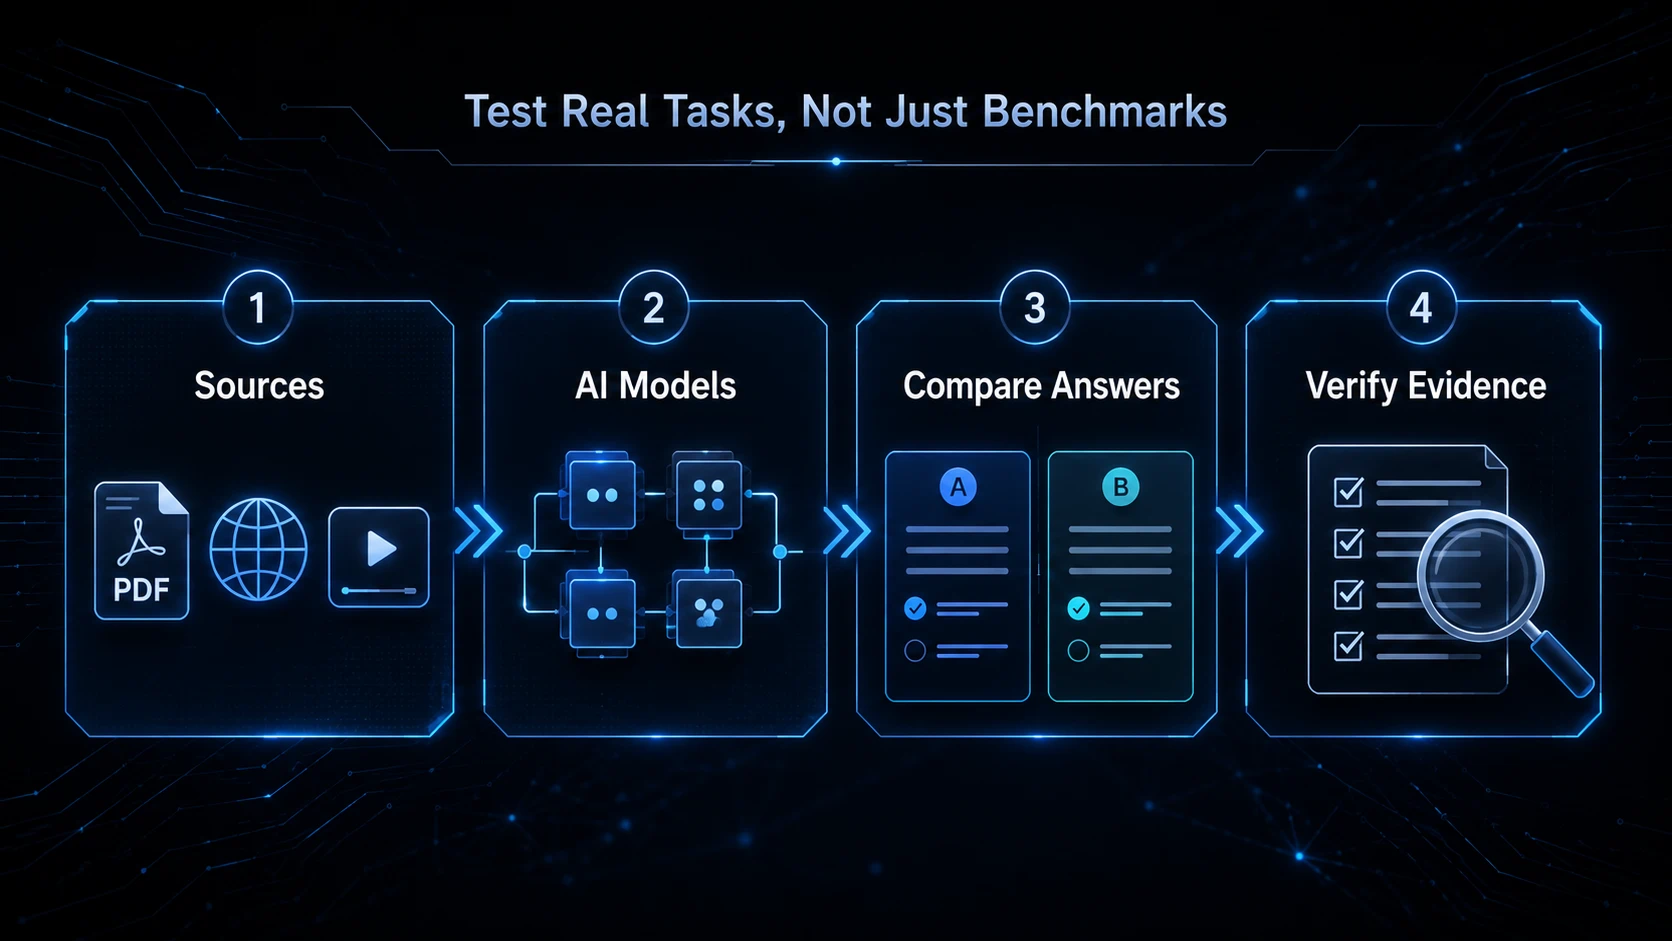
より良いテストは、同じ実タスクでモデルを比較することです。
例えば:
- 各モデルに同じ質問を与える。
- 同じソースファイルを用意する。
- 同じ指示を使う。
- 最終回答を比較する。
- 欠落情報や事実関係の誤りをチェックする。
- 重要な結論が元のソースに照らして正しいか検証する。
業務に PDF、Webサイト、動画、プレゼンテーション、リサーチドキュメントが含まれる場合、モデル同士を比較する前に、これらの資料を1か所で整理するのに iWeaver のようなツールが役立ちます。
これにより、AIモデルが単にランキングで上位なだけでなく、あなたのワークフローで実際に役立つかどうかを判断しやすくなります。
Grok 4.7 は使う価値がありますか?
コーディングやエージェント的ワークフローにおいて、Grok 4.7 は Grok 4.6 から意味のあるアップデートです。
公式のベンチマークデータでは、ソフトウェアエンジニアリング、ターミナル作業、プロフェッショナル向けタスク、電気工学、法務タスク、臨床推論で改善が示されています。
さらに、500K コンテキストウィンドウ、より強いロングタスク性能、改善された自己検証、ツール対応、そして開始時の API 価格が据え置きであることも、より大きなワークフローでモデルを実用しやすくしています。
ただし、Grok 4.7 がすべてのタスクで最適なモデルになるという意味ではありません。
モデルにはそれぞれ得意分野がありますし、ベンチマーク結果がそのまま現実の出力品質に直結するとは限りません。
それでも Grok 4.7 は、開発者やプロのユーザーにとって Grok 4.6 よりも強い選択肢を提供します。特に、タスクが多段階である場合、大量のコンテキストを扱う場合、あるいはツールを長く使う必要がある場合にその差が大きくなります。
Grok 4.7 は単なる「また別の小さな Grok アップデート」ではありません。
新しい、より大きなベースモデルを使い、ロングランのコーディング、エージェント的な作業、自己検証、プロフェッショナルな知識タスクにより強い比重を置いています。
Grok 4.6 と比べると、公式の数値では複数の厳しいベンチマークで明確な改善が示されています。一方で、開始時の API 価格は変わっていません。
今、より面白い問いは「紙の上で Grok 4.7 が Grok 4.6 より優れているか」ではありません。
その改善が、実際のプロジェクトにどれくらい持ち越されるかです。
より長い AI ワークフローを作る開発者、研究者、ユーザーにとって、Grok 4.7 が最終的に試されるのはまさにそこです。