
インテリジェント文書処理(IDP)は、AIや関連技術を活用して、文書の内容をワークフローで利用できる情報へと変換します。一般的なシステムでは、受信した文書を分類し、関連データを抽出し、結果を検証したうえで、レビュー済みの情報を次のステップへ渡します。本当の試金石は「システムがページを読めるかどうか」ではなく、「その後に続くアクションに対して十分に信頼できる結果になっているかどうか」です。
AWSのIDP解説では、業務ルールや既存データとの照合など、これらの段階を説明しています。検証ステップは重要です。もっともらしい請求書の金額でも誤っている可能性がありますし、正しく抽出された値が、すでにシステムが受け取っている請求書に属していることもあり得ます。
抽出の後に行うアクションから始める
ツールを評価する前に、この文を完成させてください:「文書が処理されたら、私たちは…する必要があります」。答えは、レコードの作成、担当者の割り当て、購買発注書との情報照合、ブリーフィングの準備などになるかもしれません。各アウトカムには、異なる確認事項と異なるレベルの自動化が必要です。
タスクが「人が要約を読む」で終わるなら、文書理解は十分な場合があります。出力が別のシステムでレコードを更新する場合は、定義されたスキーマ、検証ルール、そして例外のためのルートも必要です。抽出のデモだけでは、ワークフロー全体が準備できていることを示せないため、これらの要件はパイロット前に定めておくべきです。
IDPワークフローの段階
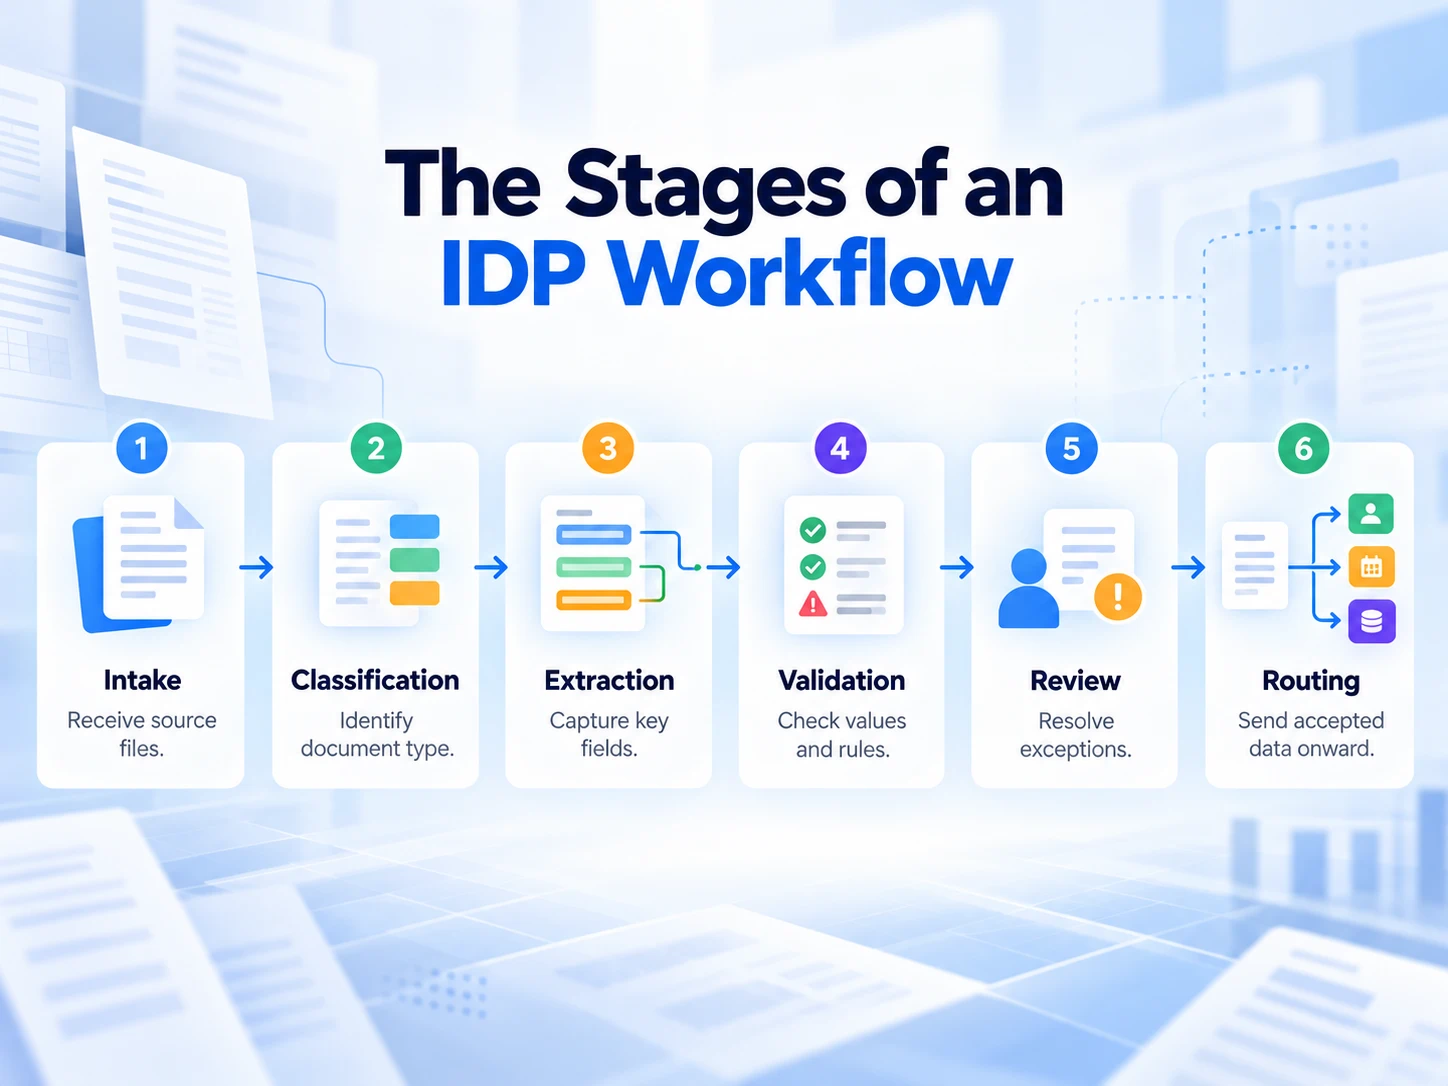
| 段階 | 目的 | 検出できない例 |
|---|---|---|
| インテーク | 送信元ファイルを受け取り、識別する | 同じファイルが2回届く |
| 分類 | 文書の種類、または関連カテゴリを判断する | 借方(クレジットノート)が請求書として扱われる |
| 抽出 | タスクに必要な項目を取り込む | 小計が合計として取り込まれる |
| 検証 | 値、関係、必須情報を確認する | 合計が合意済みの計算ルールに失敗する |
| レビュー | 曖昧、または却下された結果を解決する | 不明瞭な日付に、根拠のない推測が入る |
| ルーティング | 承認された情報を次のステップへ渡す | 有効なレコードが誤った宛先に送られる |
これは、すべてのIDP製品が6つの段階すべてを提供することを保証するものではなく、計画のためのモデルです。サービスがどのコンポーネントを提供し、何を自社で構築または設定する必要があるのかを確認してください。
分類が次の解釈を決める
文書は、別の目的のために使われていても似て見えることがあります。請求書、購買発注書、クレジットノートには、氏名、日付、金額などが含まれる場合がありますが、同じアクションを引き起こすべきではありません。分類によって、どの抽出ルールとレビュー要件を適用するかが決まります。
MicrosoftのDocument Intelligenceの概要では、抽出モデルと並んでカスタム分類器について説明しています。その区別は、「文書の種類を認識すること」と「その内容を抽出すること」が別の仕事である理由を示しています。さらに、種類が不確かな場合や、想定される範囲外に該当する場合にどうするのかも、ワークフローで定義しておくべきです。
抽出には、各項目の明確な定義が必要
「日付を抽出して」と言っても、ファイルに請求(発行)日、サービス日、支払期限が含まれている場合は曖昧になります。必要な項目と、それが出力にどのように現れるべきかを定義してください。欠損値のルールを含め、抽出をチェックするのに必要な情報は保持します。
たとえば、請求書のスキーマでは、仕入先名、請求書番号、請求書日付、通貨、合計、税などを要求することがあります。これらの項目定義では、文書に複数の候補が出てきた場合に、どの値を選ぶべきかを明示する必要があります。項目を追加するのは簡単ですが、「正しい結果とは何か」を決めるにはより慎重さが求められます。
検証は「読みやすさ」以上を確認する
一部のチェックは、その値が期待される形式になっているかを確認します。別のチェックでは、文書内の関係を確認したり、抽出データを信頼できる記録と照合したりします。日付は正しくフォーマットされていても別の出来事を表している可能性がありますし、合計は読めても明細行との整合が取れていないことがあります。
ビジネスルールと、失敗したときのアクションを定義してください。たとえば、請求書番号の欠落はレビューを必要とするかもしれません。一方で、仕入先名と請求書番号の組み合わせが繰り返される場合は、重複チェックをトリガーする可能性があります。形式チェックを通ったからといって、下流のアクションが自動的に許可されるべきではありません。
実例:請求書
次の詳細を持つ仕入先の請求書を想像してください。発行日は3月5日、支払期限は4月4日、小計は1,000、合計は1,080です。通貨は、判断できるほどはっきり印字されていません。これは製品テストの測定結果ではなく、説明のための例です。
抽出システムは、見た目の整ったレコードを返すかもしれません。請求書日付として4月4日、合計として1,000、そして推測した通貨が入っています。各値は単体ではどれも十分あり得ます。しかし一緒に見ると、IDPワークフローには、項目の意味を明確にし、レビューのルールが必要である理由がわかります。
| 要求された項目 | レビューされた値 | 承認チェック |
|---|---|---|
| 請求書日付 | 3月5日 | 支払期限ではなく発行日を使う |
| 支払期限 | 4月4日 | 請求書日付と切り分ける |
| 合計 | 1,080 | 最終合計を特定し、その構成要素を確認する |
| 通貨 | 未解決 | 未解決のままレビューを依頼する |
次に行うべき正しいステップは、通貨が重要な場所でレコードを使う前に、通貨を解決することです。推測によって作られた、一見完成しているレコードは、レビュー担当者が何を確認すべきかを明確に示す、不完全なレコードよりも役に立ちにくくなります。
OCR、Document AI、IDP、RPA
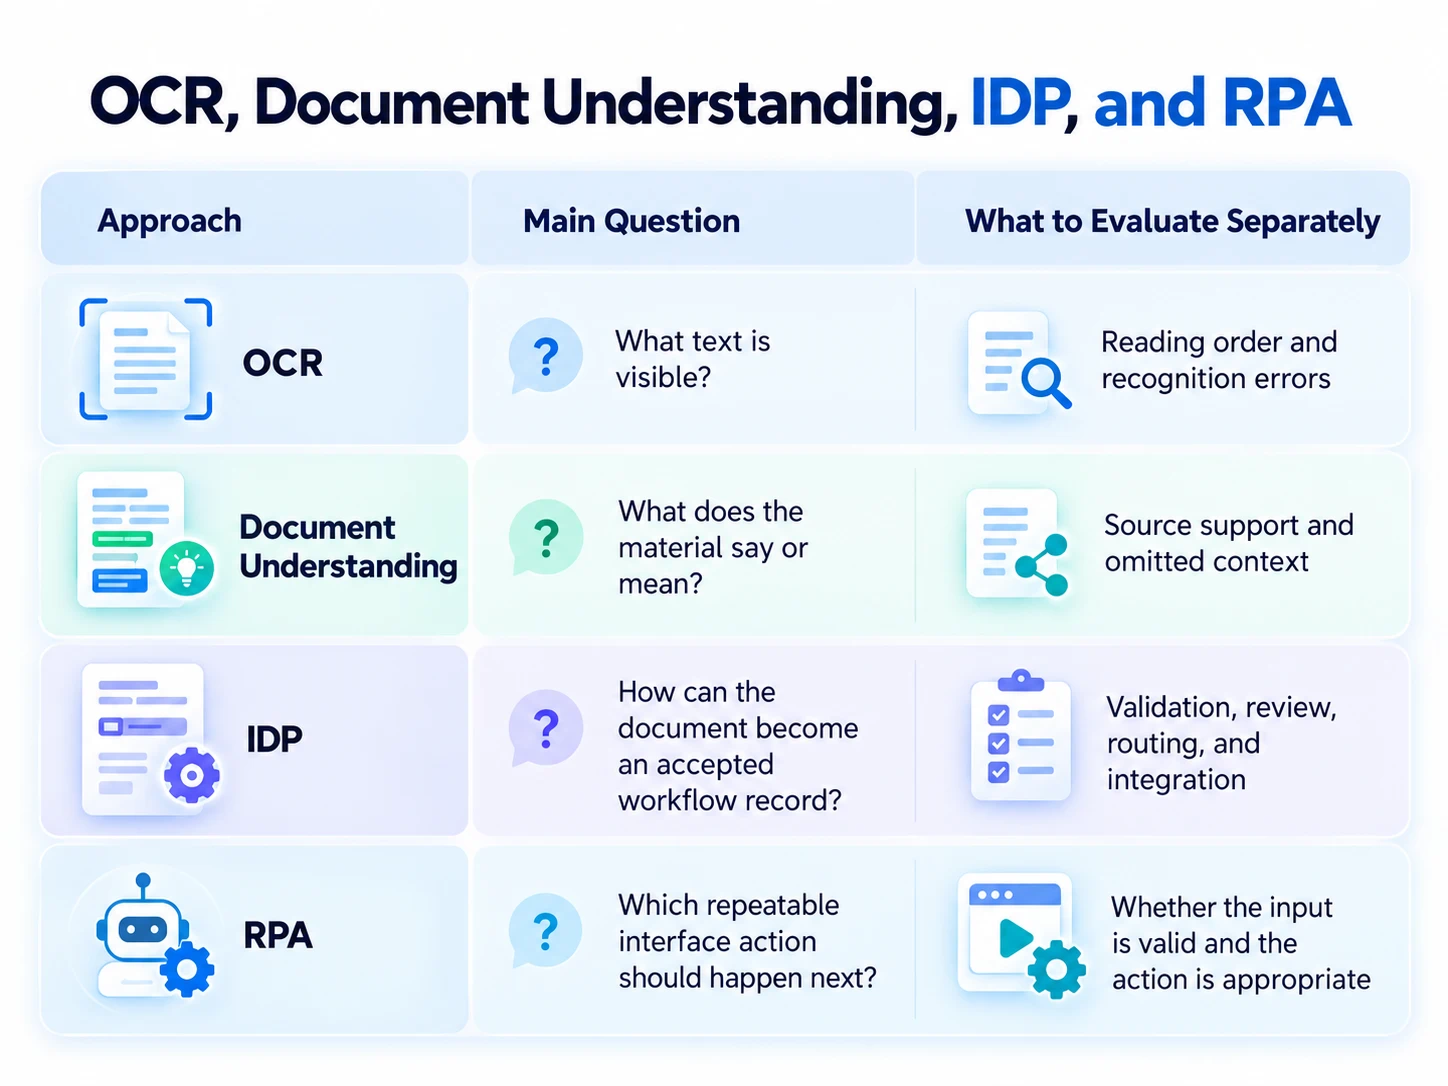
GoogleのDocument AIでは、OCR、抽出、分類のためのプロセッサが提供されています。これらのコンポーネントは、ワークフローで段階ごとに異なる能力を使う方法を示しています。抽出器が存在することは、検証ルールや例外処理が実装されているかどうかを教えてくれません。
| アプローチ | それが答える主な問い | 別々に評価すべき点 |
|---|---|---|
| OCR | どんなテキストが見えているか? | 読み取り順と認識エラー |
| 文書理解 | この資料は何を言っている(意味している)のか? | ソースの裏付けと省略された文脈 |
| IDP | 文書は、受け入れ可能なワークフローのレコードにどう変わるか? | 検証、レビュー、ルーティング、統合 |
| RPA | 次に起こすべき反復可能なインターフェース操作は何か? | 入力が有効か、そしてアクションが適切か |
境界は絶対的というより現実的です。製品によっては複数のアプローチを組み合わせます。「マーケティングのラベルがシステム全体を定義している」と決めつけるのではなく、この区別を使ってより良い評価の質問をするようにしましょう。
生成AIが役立つところ—そしてルールがまだ重要なところ
生成モデルは、指示や多様な言語を解釈できます。そのため、柔軟な抽出や文書理解にとって関連性があります。GoogleはDocument AIの提供内容の中で、生成AIベースのカスタム抽出器について説明しています。これはその製品の能力主張を裏付けるものです。しかし、あらゆるファイルやワークフローに対する普遍的な精度水準を確立するものではありません。
インテリジェント文書処理AIのパイロットでは、モデルに「推論として許可すること」を定義してください。正規化された値が必要なタスクもあれば、直接の転記が必要なタスクもあります。これらのモードを分けておくことで、レビュー担当者が「項目が明示された記述から来たのか、それとも解釈から来たのか」を判断しやすくなります。
プロンプトで「欠落しているならnullを使って」と依頼できますが、ワークフローはそれでも出力をチェックしなければなりません。流暢な説明を、項目が正しい証拠として信頼しないでください。関連するソースの該当箇所、項目定義、そして抽出後に適用されたルールを確認します。
役に立つIDPパイロットの設計方法
文書ファミリーを1つ、アウトカムを1つに絞る
たとえば、レビューのために仕入先の請求書から指定された項目を抽出する、といった範囲が限定されたタスクから始めましょう。パイロットで何を作り、例外を誰が確認するのかを定義します。最初のワークフローが理解できる前に複数の文書ファミリーへ拡大すると、失敗の原因を特定しにくくなります。
代表的な評価セットを構築する
通常の例に加え、受け取ると予想されるバリエーションを入れてください。欠落項目、見慣れないレイアウト、多ページ文書、画質の悪いスキャン、重複などです。テスト前に、レビュー担当者に期待される結果を確定してもらいます。さらに、最終評価には設定方針の判断に使わなかったファイルも含まれるよう、別で保持した「ホールドアウトセット」を用意してください。
アウトカムを適切な粒度で測定する
項目の正しさと、文書の受け入れは別の質問に答えます。システムが多くの項目を正しく取得していても、タスクを完了するのに必要な「1つの項目」を見落とすことが頻繁に起きるかもしれません。どの項目が失敗するのか、どれくらいの頻度で文書のレビューが必要になるのか、そして次のステップに進めるためにレコードが「準備できている」とは何かを記録しましょう。
これらの定義は一貫して使ってください。
- 項目の正しさ: 文書で評価した項目のうち正解だった評価項目数 ÷ 評価した全項目数(文書化された照合ルールを使用)。
- レビュー率: 人のレビューが必要な文書数 ÷ 処理した文書数。
- 受け入れ率: 定義されたすべての承認チェックを満たした文書数 ÷ 処理した文書数。
- レビュー工数: 例外の解決にかかった時間(一定の開始・終了ポイントで測定)。
これらは推奨する評価指標であり、性能主張ではありません。欠落項目と誤った値を分けて記録し、抽出エラーだけでなく下流で起きた失敗も記録してください。この区別によって、パースの改善、項目定義の書き直し、レビュー経路の調整のどれが必要かを判断しやすくなります。
自動化を増やす前に、失敗時の取り扱いをテストする
ファイルが読めない場合、文書タイプが不明な場合、または必須項目が競合する場合にどうなるかを確認してください。ワークフローは、未解決状態を見える化し、レビュー担当者が判断できるだけの文脈を保持すべきです。却下されたレコードが、次のシステムへ黙って渡らないことを検証してください。
「IDP AI」ツールを評価する場合は、代表的な自社ドキュメントを使って、例外パス(例外時の経路)を見せてもらうよう依頼しましょう。成功するデモには、通常のファイルが処理される様子だけでなく、失敗がどのように扱われるかも含めるべきです。
iWeaverがどこに当てはまるか
一部の文書業務は、運用レコードというより「理解」で終わります。レポートを読んだりブリーフィングを準備したりする場合、iWeaverは要約、AI会話、知識の整理を提供します。AI Document Summarizerは、ソース資料をレビューし、どこにより注意を払うべきかを判断するための出発点になります。
eq たとえば、分析計画を立てる前に、レポートの主張、証拠、限界についての概要を依頼します。iWeaverの公開ドキュメントワークフローは、カスタマイズされた要約と、その後の掘り下げ探索をサポートします。事実が重要であれば必ず原本を確認し、必要なエンタープライズ向けの抽出または統合の能力は、それぞれ別に評価してください。
IDPシステム選定の前に確認すべき質問
インテリジェント文書処理はOCRと同じですか?
OCRはテキストの認識に焦点を当てます。IDPワークフローでは、分類、抽出、検証、レビュー、ルーティングといった作業が追加されます。製品を比較する前に、これらの段階のうち自分のタスクに本当に必要なのはどれかを特定してください。
IDPは人のレビューなしで動かせますか?
それは、文書、承認基準、そして誤りがもたらす影響によります。どの結果は自動的に進めてよく、どれはレビューが必要かを定義してください。すべての入力に自動化が適していると決めつけるのではなく、パイロットの証拠でそのルールを設定しましょう。
IDPワークフローは不足情報をどう扱うべきですか?
不足している値を明示的に表し、定義されたルールを適用します。必須項目が欠けていると却下やレビューにつながる可能性があり、任意項目なら空のままでもよい場合があります。欠落値を推測すると、結果の監査が難しくなり、次のステップで安全に使えなくなる恐れがあります。
まず何をテストすべきですか?
次のアクションに必要な項目が、正しく抽出され、検証されているかをテストしてください。次に、例外、重複、承認されたレコードの送信先をテストします。重要な項目や失敗時の経路が信頼できないままなら、高レベルの抽出スコアだけでは不十分です。
最初のワークフローをレビュー可能にする
文書タスクを絞り込み、受け入れられる出力を定義し、通常ファイルと例外の両方をテストします。抽出を、最終結果を必ずチェックするプロセスの1つの段階として扱ってください。目先の目的が文書を理解することである場合は、ソースに基づく要約を始めて、それを使ってレビューの指針にしてください。