
KimiはK3.1 Pro Highspeedを、同じモデル機能を備えたK3.1 Proの“より速い版”として位置づけています。掲載されているベースのAPI入出力レートは、通常版の2倍です。あとは、より速い出力によって待ち時間が十分に減り、その差をワークフローの中で正当化できるかどうか——それが選択ポイントです。
無人のバッチ処理なら、通常モデルから始めるのが妥当です。多くの修正を重ねるインタラクティブな作業なら、Highspeedで“時間を測った比較”を行う価値があります。判断する前に、ツールやレビューも含めたタスク全体を計測してください。
2つのバージョンで変わること
より広いリリース文脈については、Kimi K3.1 Proの機能と提供状況をご覧ください。
| 要素 | K3.1 Pro | K3.1 Pro Highspeed |
|---|---|---|
| ベンダーの位置づけ | 通常版 | 同じ機能、より速い出力 |
| 掲載されている出力速度 | 基準値 | 約2〜3倍の基準値 |
| 1百万トークンあたりのベースAPI入力 | $2 | $4 |
| 1百万トークンあたりのベースAPI出力 | $10 | $20 |
速度はベンダーの主張であり、本記事の測定結果ではありません。APIレートやCoding Planのクォータ許容量は、課金の仕組みが異なります。
高速版は、別個の“知能アップグレード”として説明されるべきではありません。その価値は、レスポンス性と完了した作業量で評価してください。両バージョンの回答内容も、引き続き確認することをおすすめします。
シンプルなコスト例
たとえば、リクエストがキャッシュなしの入力トークン50,000個、出力トークン5,000個を使用するとします。掲載されているベースレートでの入力+出力の費用は次の通りです。
- K3.1 Pro:$0.10(入力)+$0.05(出力)=合計 $0.15
- Highspeed:$0.20(入力)+$0.10(出力)=合計 $0.30
これは仮定に基づく計算です。キャッシュ書き込み、ツール、リトライ、その他の料金は含めていません。また、トークン数が同じであることを前提にしていますが、実際の評価では推測ではなく計測で確かめるべきです。
追加の$0.15は、タスク中に意味のある時間短縮につながるなら十分に価値があるかもしれません。逆に、作業を夜間に送信して翌朝に戻るだけなら、価値が小さい可能性もあります。料金差は、人が“いつ”答えを必要としているかによって判断を変え得ます。
より速い出力=すべてのタスクが3倍の速さで終わる、ではない
ツールを併用するタスクには、いくつかの種類の待ち時間が含まれます。たとえば、モデルの生成、ドキュメントの取得、コードの実行、外部サービス、人間によるレビューなどです。Highspeedの“出力速度が速い”という主張は、シーケンス全体で同等の短縮が起きることを示しません。
たとえば、10分かかるタスクで、6分がモデル出力の生成に、残り4分がそれ以外に費やされているとします。仮に生成が3倍速になったとしても、合計は6分のままになります。内訳は「生成が2分」+「変わらない4分」です。これは役立つ節約ですが、タスク全体の所要時間が3分の1になるわけではありません。
この例は、観測されたKimiの結果ではなく計算です。目的は、あなたのワークフローで“どこを時間計測すべきか”を特定することにあります。
もし遅延の大半が長いテストスイートの実行や検索サービスの待機によるものなら、より速いモデルのエンドポイントを使えば解決できると決めつける前に、そのボトルネックを先に対処してください。
Highspeedを試す価値があるとき
モデルファミリーをまたいだ比較をするなら、Kimi K3.1 Pro vs. Claude Opus 5.5をお読みください。
Highspeedが特に向いているのは、あなたがその場にいて、モデルが次の出力を続けるのを何度も待つ必要がある場合です。たとえば、説明文の修正を行うとき、複数の実装案を順に検討するとき、あるいは文章の一部ずつを見直していくときなどです。
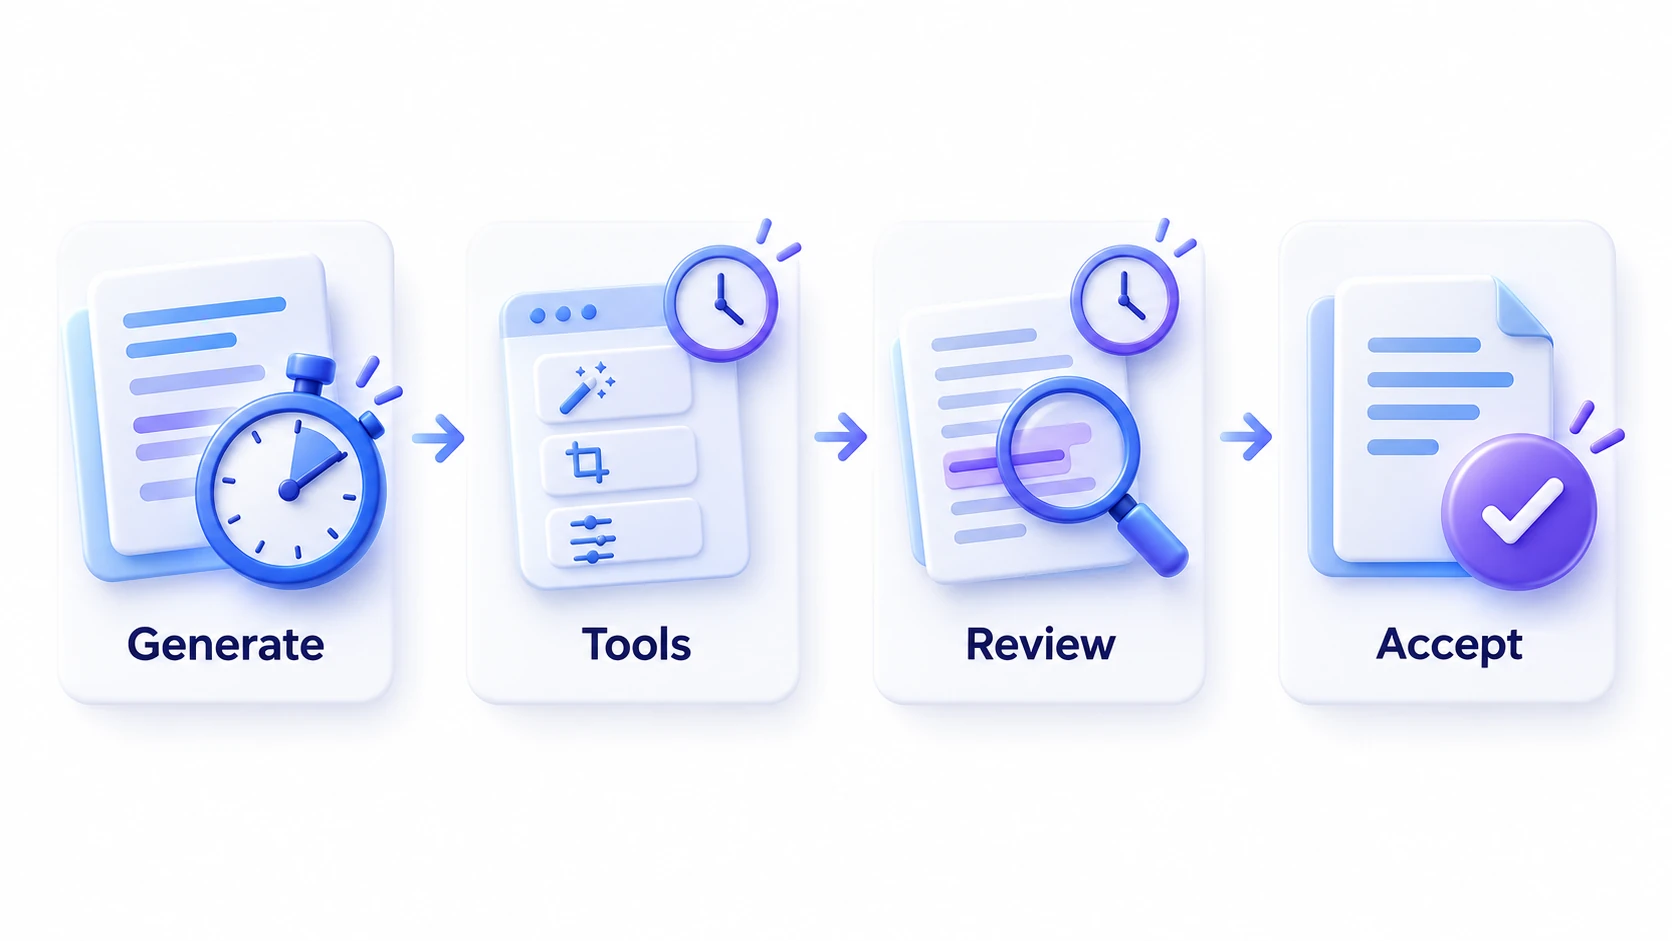
同じ代表的なタスクを両方のバリアントで実行してください。送信した時刻、有用な回答が利用可能になる時刻、そして最終結果を受け入れる時刻を記録します。修正回数を数え、誤りを直すために費やした時間も含めてください。
さらにタスクを複数回行いましょう。短い回答は両バージョンで似た体感になるかもしれませんが、長い応答では差がより大きく見える可能性があります。節約額を、選んだサービスでの“実際の追加コスト”と照らし合わせて判断してください。
通常版で十分なとき
より古いモデルから移行中なら、まずはKimi K3.1 Pro vs. Kimi K3から始めましょう。
他の作業を中断せずに完了を待てる状況では、通常のK3.1 Proから開始するのがおすすめです。たとえば、順番待ちのドキュメントレビュー、予定しているリサーチのダイジェスト、そして答えの品質が主な論点である実験などです。
また、タスクの切り取り方(フレーミング)をまだ学べていない場合は、よりシンプルな開始点を選ぶほうがよいでしょう。高速な生成だけでは、曖昧な依頼や、欠けている参照資料を解決できません。指示を改善し、根拠を確認して、それでもレスポンス性が課題のままかどうかを判断してください。
Kimi K3.1 ProはiWeaverで利用でき、iWeaverではモデルの無料トライアルが提供されています。これはHighspeedの提供状況やトライアル条件を示すものではありません。特定のバリアントを前提に計画する前に、サービスのモデルリストと現在のオファーを確認してください。
ドキュメント作業なら、AI Document Summarizerが、明確な初期の全体像を作るのに役立ちます。その全体像を使って、モデルに答えさせたい問いを絞り込みましょう。
実用的な損益分岐(ブレークイーブン)の目安を使う
ご自身の評価では、“追加コスト”と“実際に節約できた時間の価値”を比べてください。役に立つ計算方法は次の通りです。
追加のモデル費用 ÷ 節約できたアクティブ待機の分数 = 節約1分あたりのコスト
品質は最低条件として保ってください。早く届いたとしても、修正に時間がかかる回答は必ずしも時間を節約できたとは限りません。
測定した待機時間の削減が、あなたの働き方を改善し、かつ予算に収まるならHighspeedを選びましょう。低コストで期限に間に合うなら、通常のK3.1 Proを維持します。タスク構成、アクセス条件、または料金が変わった場合は、その都度選び直してください。