「フォト要約」は、意味がまったく異なることがあります。
学生なら、撮影した教科書の1ページの要約が欲しいかもしれません。プロダクトマネージャーなら、ダッシュボードのスクリーンショットから主要メッセージを取り出す必要があるでしょう。開発者なら、何千枚もの画像に対してテキスト・オブジェクト・ラベルを検出するAPIを求めるかもしれません。
しかし、それらは同じ作業ではありません。
そのため、最適なAIフォト要約ツールは、読める自然言語の要約が必要なのか、OCRなのか、視覚的推論なのか、あるいは構造化されたコンピュータビジョンの出力なのか——どこにニーズがあるかで変わります。
この2026年版の比較では、こうしたユースケースを分けて整理し、適切なタイプのツールを選べるようにしています。
クイック比較
| ツール | 向いている用途 | 抽出できるもの | 最適なユーザー |
|---|---|---|---|
| iWeaver | 構造化された画像要約 | テキスト、視覚的な文脈、グラフ、メモ | ナレッジワーカー/学生 |
| ChatGPT | 会話型の画像解析 | テキスト、オブジェクト、図、スクリーンショット | 一般ユーザー |
| Gemini | 画像Q&Aと視覚理解 | 写真、テキスト、視覚的な文脈 | 一般ユーザー |
| Adobe Acrobat AI Assistant | スキャン文書とPDF画像 | OCRに加え、文書レベルの文脈 | PDFを扱うことが多い人 |
| Google Cloud Vision | OCRおよび機械学習向けビジョンAPI | テキスト、ラベル、オブジェクト、ランドマーク | 開発者 |
| Azure AI Vision | OCR、キャプション、画像解析 | テキスト、キャプション、オブジェクト | 開発者/企業 |
| Amazon Rekognition | 大規模な画像検出 | ラベル、オブジェクト、テキスト、モデレーションのシグナル | 開発者/AWSチーム |
1. iWeaver — 構造化された画像要約に最適
iWeaverのAI Image Summarizerは、「画像の中身を検出するだけ」ではなく、画像を理解したい人のために設計されています。
次のような用途で使えます。
- スクリーンショット
- グラフ
- ビジュアルメモ
- スキャンしたページ
- インフォグラフィック
- プレゼンテーションのスライド
- テキストを含む画像
便利なのは、出力の構造化です。OCRテキストやラベルだけを返すのではなく、画像を主要ポイント、説明、メモ、またはフォローアップの回答へと変換できます。
研究、学習、ビジネスレビュー、そしてナレッジのワークフローで実用的な選択肢になります。
こんなときにおすすめ: 続けて作業に使える、人が読める要約が欲しい場合。
2. ChatGPT — 会話型の画像解析に最適
ChatGPTは、アップロードした画像を解析し、見えている内容について質問に答えられます。
最初の要約が、さらに疑問につながるときに役立ちます。
たとえば:
このダッシュボードを5つの箇条書きで要約してください。
そして:
どの指標が最も変化しましたか?
さらに:
その結果を、私のチーム向けの短いアップデートにしてください。
同じアプローチは、図、スクリーンショット、撮影した文書など、多くの視覚入力にも使えます。
強みは、固定の「フォト要約」形式ではなく柔軟性にあります。
重要度の高い詳細については、数字・ラベル・小さな文字を元の画像と照合してください。
こんなときにおすすめ: 画像を対話的に議論し、その結果を別のアウトプットへ変換したい場合。
3. Gemini — 一般的な画像Q&Aに最適
Geminiは画像のアップロードに対応しており、写真や視覚コンテンツについて質問に答えることができます。
日常的な用途では、次のようなタスクに向いています。
- スクリーンショットに何が写っているかを説明する
- 画像からテキストを読む
- 撮影したページを要約する
- 見えている要素を特定する
- 複数の視覚的な詳細を比較する
また、Lensや画像理解に関する長い歴史も、Googleの視覚エコシステムの強みになっています。
マルチモーダルのアシスタント同様に、良いプロンプトでは「観察」と「解釈」を分けるのがポイントです。
試してみてください。
まず、見えているものを一覧にしてください。次に主要メッセージを要約します。読めない文字があれば、必ず印をつけてください。
こんなときにおすすめ: 手早い分析のために、汎用の視覚アシスタントが必要な場合。
4. Adobe Acrobat AI Assistant — スキャン文書に最適
「写真」は、実際には文書のページが画像として取り込まれているケースがよくあります。
入力がスキャンPDF、報告書、契約書、アーカイブ文書であるなら、一般的なフォト解析よりも、Adobe Acrobat AI Assistantのほうが適している可能性があります。
このワークフローはOCRと文書の文脈を組み合わせており、ファイルを個別の画像に分割せずに、スキャンしたテキストから要約や質問へ進められます。
特に、ページの順序や文書構造が重要な場合に役立ちます。
こんなときにおすすめ: 画像が主にPDF内のページである場合。
5. Google Cloud Vision — OCRと画像APIに最適
Google Cloud Visionは、一般向けの要約ライターではありません。開発者向けのコンピュータビジョンサービスです。
印字または手書きのテキストを検出し、ラベルやその他の視覚シグナルを含む、画像に関する構造化された情報を返せます。
そのため、自分で要約のパイプラインを作りたいときに役立ちます。
典型的なワークフローは次のとおりです。
画像 → Cloud VisionのOCR/ラベル → 構造化データ → 言語モデル → 最終要約
これにより、抽出・保存・信頼度チェック・下流の処理を開発者がコントロールできます。
手動アップロードのツールでは現実的でない、大規模な自動化にも特に有用です。
こんなときにおすすめ: APIを通じて画像理解が必要なアプリケーションを開発している場合。
6. Azure AI Vision — エンタープライズ向けコンピュータビジョンに最適
Azure AI Visionは、Microsoft中心の開発環境向けにOCRと画像解析機能を提供します。
使用するサービスやモデルによって、テキストを抽出したり、視覚的な要素を特定したり、より大きなAIワークフローに渡せる説明的な情報を生成したりできます。
企業チームにとっての主な価値は「統合」です。画像解析は、ストレージ、検索、オートメーション、言語モデルなどを含む、より広範なAzureのアーキテクチャの中の1コンポーネントになり得ます。
1枚のスクリーンショットをアップロードして、洗練された学習用の要約を受け取るような体験とは同じではありません。
こんなときにおすすめ: 組織が、画像処理をAzureベースのシステムに組み込もうとしている場合。
7. Amazon Rekognition — AWSの画像検出ワークフローに最適
Amazon Rekognitionは、もう一つの開発者向けの選択肢です。
複数の画像にわたって、ラベル、オブジェクト、テキスト、その他の視覚シグナルを検出できます。すでにAWSを使っているチームは、この構造化された出力をデータベース、モデレーションシステム、検索パイプライン、または言語モデルに接続できます。
「要約」については、Rekognitionは通常、最終的な文章生成というより知覚(perception)レイヤーとして機能します。
この違いが重要です。コンピュータビジョンAPIは、その画像に人物、自転車、道路、テキストが含まれていると伝えてくれるかもしれません。一方、マルチモーダルの言語ツールは、それらの観察を自然言語の説明へ変換するのに向いています。
こんなときにおすすめ: AWSのワークフロー内で、スケーラブルな画像解析が必要な場合。
画像要約ツール vs. OCRツール:何が違う?
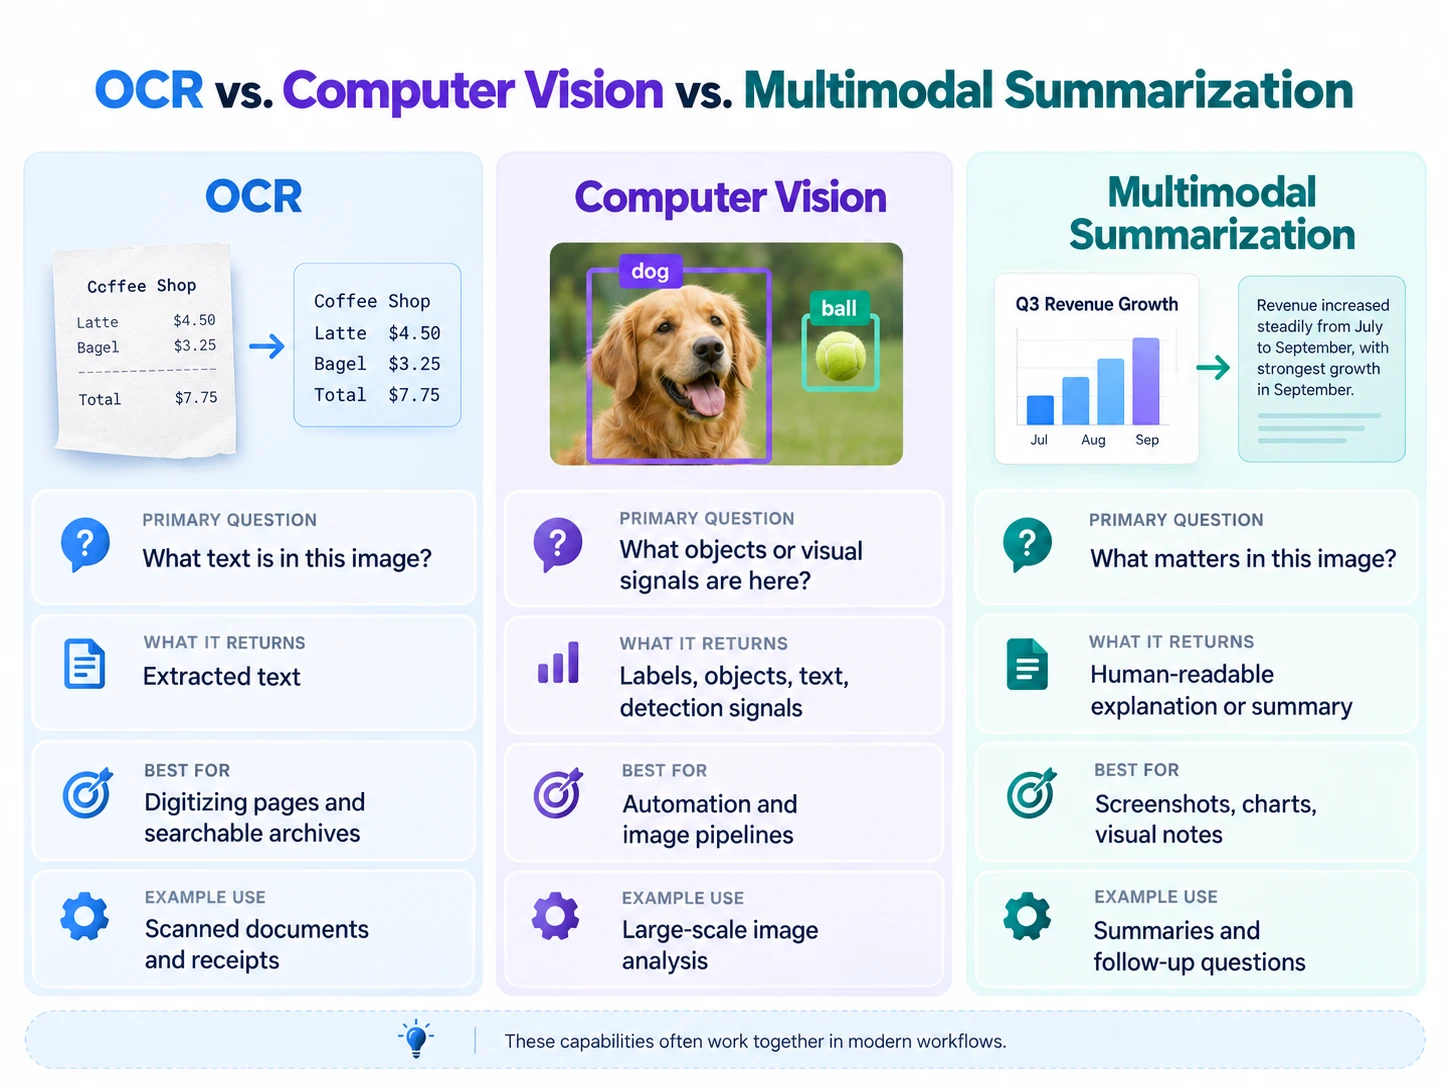
OCRはこう答えます:
この画像にはどんなテキストが含まれていますか?
画像要約ツールはこう答えます:
この画像で重要な点は何ですか?
マルチモーダルアシスタントは、さらに踏み込みます:
私の質問の文脈では、その画像は何を示唆していますか?
これらの機能は重なりますが、同じものではありません。
印字されたテキストをデジタル化するだけなら、OCRで十分な場合があります。スクリーンショット、グラフ、ビジュアルメモを簡潔に説明する必要があるなら、テキストとレイアウトの両方を理解できるツールを使いましょう。
手順ベースのワークフローについては、画像からテキストを要約する方法をご覧ください。
適切なツールの選び方
次の4つの質問をしてみてください。
1. 重要な情報は主にテキストですか?
はいなら、OCRの品質を優先します。
手書きの場合は、専用のAI Handwriting Recognitionワークフロー、または手書き向けに設計された別のOCRツールを使ってください。
2. レイアウトは重要ですか?
グラフ、ダッシュボード、スライド資料、インフォグラフィックでは、テキスト抽出だけでは足りません。
位置、ラベル、凡例、視覚的な関係性を推論できるマルチモーダルツールを選びましょう。
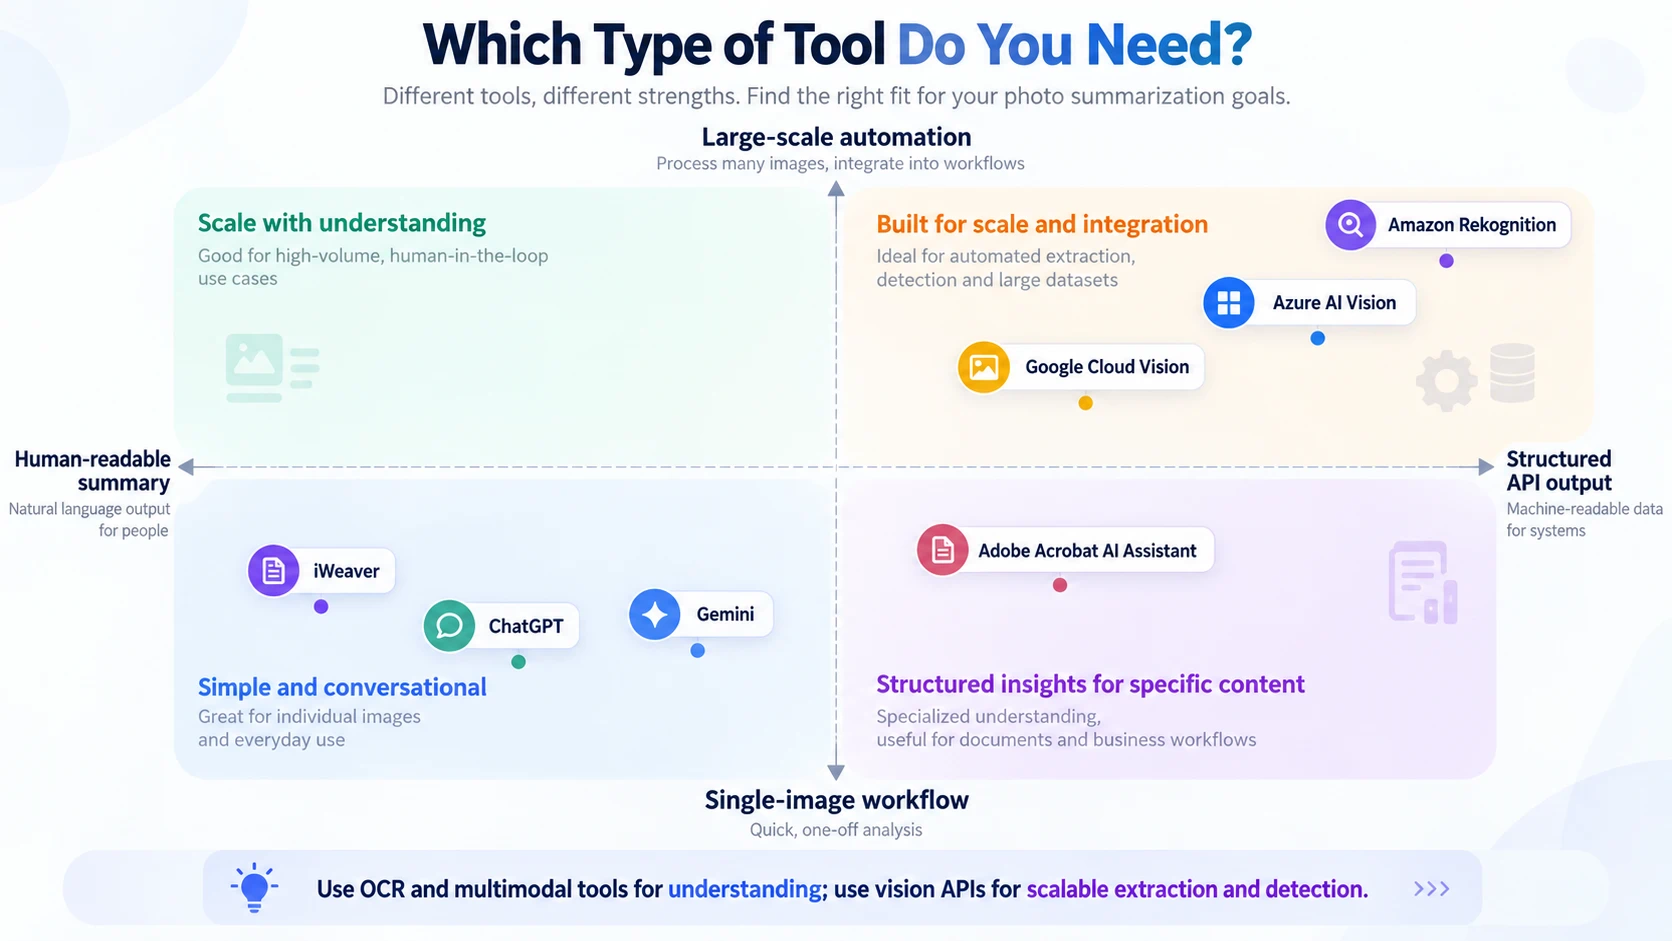
3. 必要なのは1枚の画像ですか?それとも何千枚ですか?
単発の手作業での分析なら、ユーザー向けの要約ツールのほうがシンプルです。
数千〜数百万枚なら、Google Cloud Vision、Azure AI Vision、Amazon RekognitionのようなAPIのほうが適しています。
4. 要約のあと、何が必要ですか?
フォローアップの質問をしたい、画像を比較したい、メモを作りたい、結果を別の文書にまとめたい——なら、会話型のワークフローを持つツールを選びましょう。
ソフトウェアシステム向けに構造化されたラベルだけが必要なら、APIで十分な場合があります。
より良いフォト要約のためのプロンプト例
ダッシュボードの場合:
ダッシュボードを5つの箇条書きで要約してください。表示されている日付範囲と、指標の数値は正確に保ってください。観察と、考えられる説明は分けてください。
スキャンしたページの場合:
テキストを抽出してから、主要な主張を要約してください。固有名詞、日付、引用はそのままの形で保ってください。読めない文字は推測せず、マークしてください。
グラフの場合:
軸、グループ、トレンド、最高値と最小値、そして見えている異常点を説明してください。相関から因果関係を推測しないでください。
複数のスクリーンショットの場合:
まず各スクリーンショットを個別に要約してください。その後、すべての画像に共通する課題、違い、そして最も重要な結論を3つにまとめてください。
具体的なプロンプトにすると、ツールが視覚的にはわかりやすいが重要ではない細部に注目してしまう可能性を下げられます。
プライバシーは重要
画像をアップロードする前に、それ以外に何が写っているか確認してください。
スクリーンショットには、氏名、メールアドレス、社内ダッシュボード、顧客情報、口座番号、またはプライベートメッセージなどが含まれることがあります。
不要な情報はトリミングまたは秘匿(レッド)し、機密画像については組織が承認したデータ取り扱いポリシーに従ってください。
最適なAIフォト要約ツールは、作業によって変わります。
a読みやすい説明とフォローアップが欲しいときはiWeaver、ChatGPT、Geminiを選びましょう。「写真」が実際にはスキャン文書である場合はAdobeを使います。ソフトウェアに画像理解を組み込むなら、Google Cloud Vision、Azure AI Vision、Amazon Rekognitionを選んでください。
重要な違いはシンプルです。OCRはテキストを抽出し、コンピュータビジョンは視覚的な要素を検出し、マルチモーダル要約はそれらのシグナルを意味へと変換します。