
AnthropicはClaude Fable 5.2 と Claude Mythos 5.2をリリースし、コーディング、科学研究、推論、複雑な技術ワークフローに大幅な改善をもたらしました。
注目すべき主要な変更点は見逃せません。出力生成が最大30%高速化され、標準API価格が20%引き下げられ、複数の負荷の高いベンチマークでより強いパフォーマンスを発揮します。
しかし、重要な違いがあります。Fable 5.2 と Mythos 5.2 は同じ基盤となるAIモデルを共有しています。それらを分けているのは、Anthropicがセンシティブなサイバーセキュリティおよび生物学研究の機能へのアクセスをどのように管理しているかです。
この記事では、何が変わったのか、2つのモデルをどう比較できるのか、そして実際にあなたが必要としているのはどちらなのかを解説します。
Claude Fable 5.2 と Mythos 5.2 とは?
Claude Fable 5.2 と Mythos 5.2 は、Anthropicの最新のフロンティアモデルで、とりわけ難易度の高い技術・研究課題向けに設計されています。
日常的な会話を主に最適化したモデルとは異なり、これらのリリースは、長めの推論が必要になる可能性があるタスク、複雑なコード実行、ツールの活用、そして複数ラウンドの実験を伴う作業に焦点を当てています。
Claude Fable 5.2 は、広く利用可能なバージョンです。一定の高リスクなサイバーセキュリティおよび生物学研究に関する活動を制限するガードレールが含まれています。
Claude Mythos 5.2 は、サイバーセキュリティおよびライフサイエンス領域での、認証済み組織向けに特化した機能を提供します。
| 機能 | Claude Fable 5.2 | Claude Mythos 5.2 |
|---|---|---|
| 基盤モデル | 共通の土台 | 共通の土台 |
| 主な対象 | 開発者、エンジニア、研究者 | 認証済みのセキュリティ/ライフサイエンスチーム |
| コーディングと推論 | 高度 | 高度 |
| サイバーセキュリティ機能 | ガードレールにより制限 | 拡張された認可済み機能 |
| 生物学研究 | センシティブ領域で制限 | 承認された研究で利用可能 |
| 一般提供 | 広く提供 | 認証が必要 |
| 標準API価格 | 入力 $8 / 出力 $40 | 入力 $8 / 出力 $40 |
API価格は100万トークンあたりです。基盤モデルが共有されていても、アクセスとガードレールは異なります。

Claude Fable 5.2 の新機能
1. コーディングとソフトウェアエンジニアリングの強化
改善が最もわかりやすい領域のひとつがコーディングです。
AIが生成したコード変更が、実際のオープンソースプロジェクトに求められる基準を満たすかどうかを評価するFrontierCode 2.0で、Fable 5.2は**Xhigh effortで49.1%**を記録し、Fable 5.1の32.4%と比べて大きく伸びました。
またAnthropicは、Fable 5.2の初期バージョンを実行するエージェントによって、PythonからRustへの本番移行が行われたと報告しています。移行されたサービスの開始は、約26倍高速だったとのことです。
別の実験では、Fableが1,000を超えるAIサブエージェントを連携させ、ノートPCで起動できるプロトタイプのOSを構築しました。
これらの例は、高度なコーディングアシスタントの使われ方が変わりつつあることを示唆しています。単発のコード提案を行うのではなく、モデルがエンドツーエンドのエンジニアリング案件で試されるケースが増えています。
とはいえ、コードレビュー、セキュリティチェック、人による承認が不要になるわけではありません。
2. 応答の高速化と効率の向上
Anthropicによると、Fable 5.2 と Mythos 5.2 は先行の5.1よりも最大30%速く出力を生成します。
さらに、任意で利用できる高速モードを導入し、トークン生成速度を最大2.5倍にできるとしています。
長時間のコーディングセッションやマルチエージェントのワークフローを行う開発者にとっては、生成が速くなることで反復の間にかかる待ち時間を減らせます。
ただし、より速い出力が必ずしも安くなるとは限りません。高速モードは標準のトークンレートの2倍の費用がかかるため、短縮できる時間が追加コストに見合うかをチームで評価する必要があります。
3. 科学研究と数学的推論
Anthropicの発表の中でも、特に意欲的な主張の一部は研究に関するものです。
同社によると、Fable 5.2は、ブラックホールと量子重力を含む2つの未解決の基礎理論物理学問題の解決に寄与したとのことです。
また、30時間でフェルマーの最終定理の証明を形式化するために、約1,000のエージェントを調整したと報告しています。形式化とは、数学の証明をソフトウェアが段階的に検証できる形に変換することです。定理の「元の証明」を発見するのとは同じではありません。
一方でMythos 5.2は、複雑なウイルスタンパク質構造をモデル化するための計算アプローチの開発に役立ちました。Anthropicは、テストした34種類のカプシドのうち28で正確なモデルを報告したとしています。
これらの結果は、AI支援による科学研究の機会が広がっていることを示しています。ただし、あくまで報告されている特定の研究デモであり、モデルが任意の科学問題を独力で解けることの証拠になるわけではありません。
Claude Fable 5.2 ベンチマーク:どれくらい良くなった?
Anthropicは、プログラミング、ビジネスのワークフロー、推論、研究にまたがる比較を公開しました。
| ベンチマーク | Fable 5.1 | Fable 5.2 |
|---|---|---|
| FrontierCode 2.0 | 32.4% | 49.1% |
| FrontierSWE v2 | 56.3% | 69.9% |
| AutomationBench | 31.4% | 51.4% |
| Humanity's Last Exam(ツールあり) | 65.6% | 74.2% |
| Chartography(ツールなし) | 44.8% | 73.4% |
出典:結果は一般に各モデルの利用可能な「最高のeffort設定」を反映しており、同一コストの比較として解釈すべきではありません。
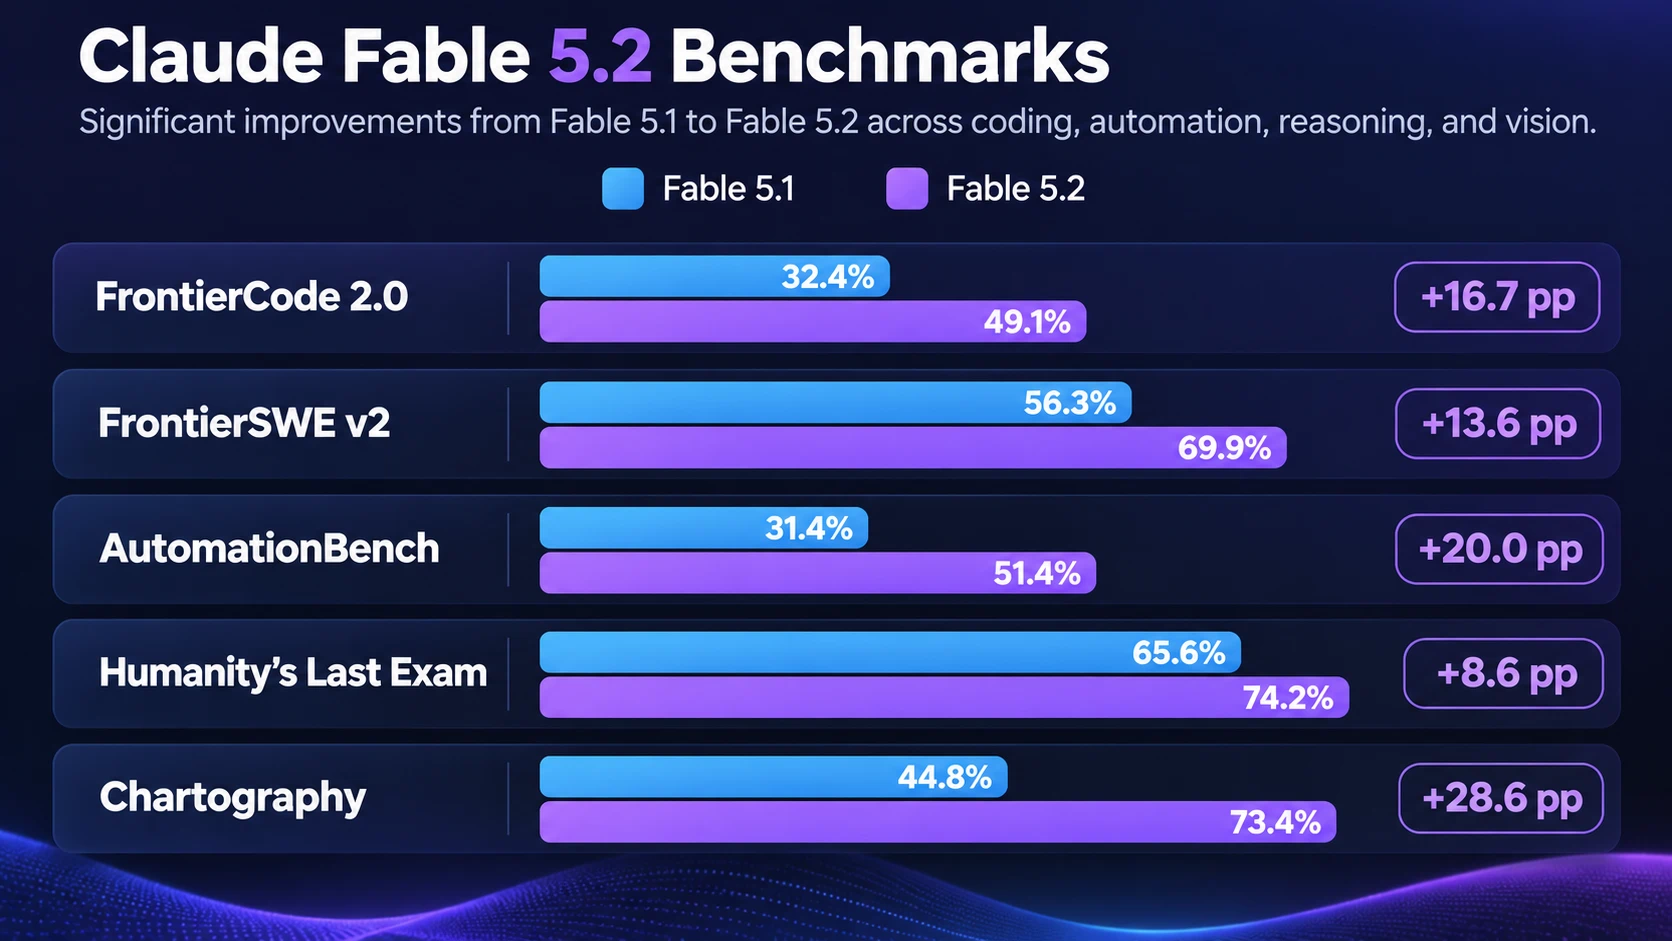
知識労働者にとっては、チャートの解釈とビジネス・ワークフローのパフォーマンスが特に関心を引くかもしれません。これらは、レポートの分析、図表の読み取り、複数ステップの情報問題を解き進めるといったタスクに関係しています。
とはいえ、ベンチマークには限界があります。パフォーマンスはタスクの複雑さ、利用可能なツール、推論設定、そして結果の評価方法に左右されます。
ベンチマークスコアが高いことは、そのモデルを自分のワークフローで試すための理由にはなりますが、あらゆる状況で常により良い結果が得られる保証ではありません。
Claude Fable 5.2 と Mythos 5.2 の価格
Anthropicは、前世代と比べて標準API価格を引き下げました。
| 100万トークンあたりの価格 | 5.1生成 | 5.2生成 |
|---|---|---|
| 標準入力 | $10 | $8 |
| 標準出力 | $50 | $40 |
| 高速モード入力 | — | $16 |
| 高速モード出力 | — | $80 |
新しい標準価格は、入力・出力のコストの両方で20%の値下げを意味します。
大量の情報を処理する企業にとっては、高度な推論ワークフローをより経済的にできる可能性があります。
ただし実際の費用は、トークン消費量、effort設定、キャッシュ、ツールの利用、そしてタスク完了に必要な試行回数によって変わります。
Claude Mythos 5.2:なぜアクセスが制限されているの?
Claude Mythos 5.2は、特にサイバーセキュリティの専門家や生物学研究者にとって関連性が高いモデルです。
Anthropicは、新しいモデルが従来世代よりも効果的にソフトウェアの脆弱性を特定し、再現し、修正を助けられると述べています。
報告されているCV E Rediscoveryの結果は89.6%に到達しており、Mythos 5.1の78.3%と比べて改善しています。
こうした能力は、認可された防御側が弱点を調査するのに役立ちますが、同時に悪用リスクも生みます。
そのためAnthropicは、Cyber Verification ProgramおよびLife Sciences Verification Programを通じて、直接のMythosアクセスを制限しています。
Fable 5.2は、これらの領域でもより強いガードレールを維持しています。Anthropicによると、更新されたガードレールにより、Fable 5.1より不要なブロックが少なくなるということです。
この方針は、より広いAI業界の課題を反映しています。有用な高度機能を提供しつつ、能力がますます高まるモデルに伴うリスクを管理することです。
Claude Fable 5.2 と Mythos 5.2 にアクセスする方法
Claude Fable 5.2は、対応しているClaudeサービスおよび主要なクラウドプラットフォームで利用可能です。Amazon Web Services、Google Cloud、Microsoft Azureを含みます。
開発者は次のモデル識別子を使用できます:
claude-fable-5-2
またAnthropicは、ローンチ週において、対象となる有料のClaudeサブスクライバーに一時的な追加のFable利用枠を提供すると発表しました。
Claude Mythos 5.2は、適切な認証プログラムを通じたアクセスが必要です。なおClaude Enterpriseのお客様は、Anthropicのより広いモデルファミリーの機能を組み込んだClaude Securityを利用できます。
Anthropic経由での提供があることは、すべてのサードパーティAIプラットフォームがすでにこれらのモデルを統合済みであることを意味しません。
Fable 5.2 と Opus 5.5:どちらを選ぶべき?
Fable 5.2の優れた能力にもかかわらず、Anthropicは「何でもFable 5.2を使う」ことは推奨していません。
ほとんどの普段のプログラミングや知識作業では、同社はClaude Opus 5.5から始めることを推奨しています。
Fable 5.2がより適しているのは、タスクが十分に難しく、追加の推論リソースを使う価値がある場合です。
たとえば、複雑なソフトウェア移行、長めの研究課題、複雑なエンジニアリング分析、またはマルチエージェントの連携が必要なケースではFable 5.2を検討してください。
一方で、定型的な文章作成、ドキュメント要約、通常のコーディング、単純な質問であれば、より低コストなモデルで十分な場合があります。
実務的な判断は単純に「どのモデルが最高スコアか」ではありません。利用可能な時間と予算の中で、信頼できる結果をもたらすモデルはどれか、ということです。
研究・知識作業にとって、これは何を意味する?
今回のリリースは、AIが個々の回答を生成する段階から、より長く、つながったワークフローを扱う方向へ進んでいることを示しています。
ただし、モデルが推論に強くなったとしても、人は重要な意思決定の背景にあるドキュメント、研究、データを理解する必要があります。
そこで役立つのが、整理された情報ワークフローです。
iWeaverなら、次のことができます:
- 選択したドキュメントや参照の範囲で質問を掘り下げるために、AI Knowledge Base を使う。
- Research Paper Analyzer で、学術的な手法、発見、限界を確認する。
- Financial Statement Analysis を通じて、財務レポート、指標(比率)、トレンドを見極める。
これらのツールは、バラバラの情報源を、元データと照合して検証できる形の構造化されたノートと分析に変えるのに役立ちます。
また、すべてのドキュメント作業で最も計算量の多いモデルを使う必要なく、より強力なAIシステムへの広がりを補完してくれます。
Claude Fable 5.2 は Claude Opus 5.5 より優れている?
Fable 5.2は多くの高度なベンチマークで性能が高く、特に難しいコーディングや研究タスクで強みを発揮します。ただしAnthropicは、多くの定型的なコーディングや知識作業の開始点としてOpus 5.5を推奨しています。
Claude Fable 5.2 と Mythos 5.2 の違いは?
どちらも同じ基盤モデルを共有しています。Fableはセンシティブなサイバーセキュリティや生物分野のタスク向けに、より強いガードレールが含まれています。一方Mythosは、これらの分野で働く認証済み組織向けに特化したアクセスを提供します。
Claude Fable 5.2は無料?
AnthropicはFable 5.2を広く提供していますが、利用は該当するClaudeプラン、プラットフォームの制限、またはAPI課金の取り決めに依存します。広い提供=無制限の無料アクセスを意味するわけではありません。
Claude Fable 5.2はいくら?
標準のAPI価格は、入力トークン100万あたり$8、出力トークン100万あたり$40からです。任意の高速モードは、それぞれ$16と$80です。
誰でも Claude Mythos 5.2 を使える?
いいえ。直接のアクセスは、Anthropicの認証プログラムを通じて対象となる組織に制限されています。また、Mythos搭載の特定のセキュリティ機能は、Claude Enterpriseの提供としても利用可能です。
Claude Fable 5.2 と Mythos 5.2は、より大きく、要求水準の高い技術プロジェクトを扱えるAIシステムへ向けた、意味のある一歩です。
コーディング、科学研究、推論の改善は特筆に値し、特に標準API価格の低下と並んで注目できます。
ただし、最も重要なポイントは「これらのモデルがどう使われることを意図しているか」です。最難関の問題にはより強いモデル、日常のタスクにはより小さなモデル、そして全過程で人の監督を行うこと。
日常的な研究や大量のドキュメント作業では、当面の最優先事項は変わりません。情報源を整理し、証拠を精査し、得た情報を役立つものへと変えていきましょう。
iWeaver を使って、研究資料を1つのAIワークスペースで要約・分析・整理しましょう。