
Claude Sonnet 5.5 と GPT-6.1 Sol は、標準の API トークン価格が同じですが、強みはそれぞれ異なる設計です。Sonnet 5.5 は、速くて範囲が明確なコーディングやプロフェッショナルなタスクに向けて位置づけられています。GPT-6.1 Sol は、複雑なコーディング、コンピューターの利用、ツール主導の作業、プロフェッショナルなワークフローを対象としつつ、低コストで Astra に近い性能を提供します。
実際の選び方は、タスク次第です。Sonnet 5.5 は、制約のあるコーディング、洗練されたドキュメント、スライド、スプレッドシートに対してトライアルする価値があります。GPT-6.1 Sol は、非常に大きなコンテキストウィンドウ、OpenAI の Responses API ツール、またはマルチステップのワークフローが必要な場合の有力な候補です。iWeaver は GPT-6.1 Sol の無料トライアル を提供しており、モデルを選ぶ前に、自分のドキュメントやリサーチ課題で実際に試せます。
Claude Sonnet 5.5 vs GPT-6.1 Sol:ひと目でわかる比較
| 詳細 | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| 標準入力価格 | $2 per 1M tokens | $2 per 1M tokens |
| 標準出力価格 | $10 per 1M tokens | $10 per 1M tokens |
| キャッシュ読み取り価格 | $0.20 per 1M tokens | $0.10 per 1M tokens |
| コンテキストウィンドウ | 選択した Claude プラットフォームを確認 | 1,050,000 tokens |
| 最大出力 | 選択した Claude プラットフォームを確認 | 128,000 tokens |
| 明示されている注力点 | 範囲の明確なコーディングとプロフェッショナルなタスク | 複雑なコーディング、コンピューターの利用、プロフェッショナルな作業 |
| 推論コントロール | 努力量を調整可能 | low, medium, high, xhigh, max |
| API モデル名 | claude-sonnet-5-5 |
gpt-6.1-sol |
GPT-6.1 Sol の数値は OpenAI のモデルドキュメント に基づきます。Sonnet 5.5 の価格と位置づけは Anthropic のリリース発表 に基づきます。ロングコンテキストの価格、バッチ処理、ファストモード、キャッシュ書き込み、ツール呼び出し、クラウド事業者の条件によって、最終コストは変わり得ます。
コーディング:生の能力と同じくらい「スコープ管理」が重要
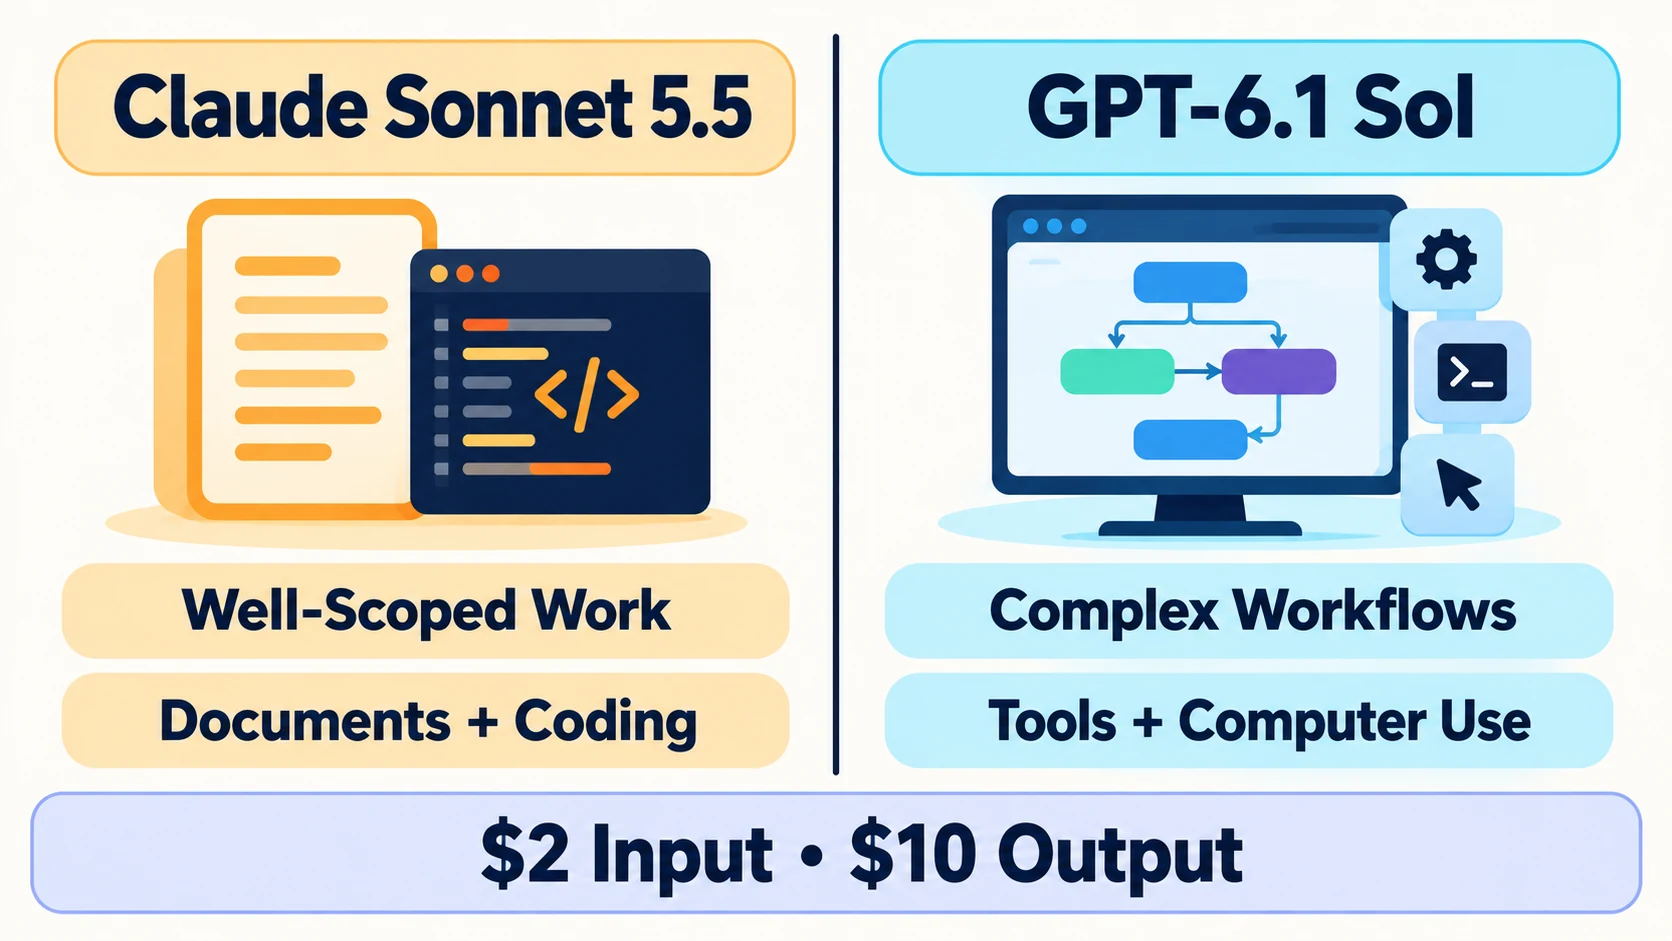
Anthropic は Sonnet 5.5 を、日常的なプロフェッショナル作業やバグ修正、そして明確に範囲が定まったタスク向けの高速モデルとして位置づけています。リリース資料では、Terminal-Bench 4.0 で 70.6%、FrontierCode 1.1 Main で Max effort の 46.2% といった、強力なコーディング結果が報告されています。
GPT-6.1 Sol は、複雑なコーディングやエージェント的な作業向けに位置づけられています。OpenAI は Responses API を通じて、コード実行、ホストされたシェル、パッチの適用、コンピューター利用などのツールへのアクセスも提供しています。
しかし、これらの事実は「万能な勝者」を示すものではありません。コーディング評価では、同じリポジトリの課題、指示、環境、時間予算を使ってテストするべきです。モデルが正しい原因を見つけられたか、必要なファイルだけを変更したか、適切なチェックを実行したか、タスクが完了した時点で止められたかを確認してください。
タスクが限定的で、素早い反復が重要なら、Sonnet 5.5 をトライアルで選びましょう。より広いリポジトリ文脈、ツールの連携、そして実装と検証を複数段階で行う必要があるなら、GPT-6.1 Sol をトライアルで選ぶのがおすすめです。
ドキュメントとナレッジワーク
Sonnet 5.5 は、洗練されたドキュメント、スライド、スプレッドシートの作成に明確に向けて位置づけられています。Anthropic のリリース根拠でも、Sonnet 5 と比べて専門知識に基づく仕事の質と効率が改善している点が強調されています。
GPT-6.1 Sol は、ドキュメント向けに 1,050,000 トークンのコンテキストウィンドウと、最大 128,000 トークンの出力が利用できることが明記されています。そのため、大規模なドキュメント群、リサーチの統合、ポリシーのレビュー、詳細で構造化された成果物に対して魅力的な選択肢になります。
ただし、コンテキスト容量だけでドキュメントの質は証明できません。同じソースパケットで両モデルをテストし、図表を抽出すること、相反する記述を突き合わせること、証拠と推論を見分けること、そして各結論がどこから来たのかを示すように依頼してみてください。より監査しやすい結果を出すモデルのほうが、最初の下書きをよりスムーズに書くモデルより価値が高い場合があります。
ツールとワークフローの適合性
GPT-6.1 Sol の最も明確な強みは、Responses API を通じて利用できるツールの実装がドキュメント化されている点です。Web 検索、ファイル検索、画像生成、コード実行、ホストされたシェル、コンピューター利用、MCP、ツール検索をサポートしています。これは、すでに OpenAI のエージェントスタックをベースに構築しているチームにとって、統合の摩擦を減らせる可能性があります。
Sonnet 5.5 は Claude 製品、Claude Platform、AWS、Google Cloud、Microsoft Azure で利用できます。これらの環境をすでに使っている組織や、Claude 向けにプロンプトや評価を調整済みの組織では、より自然にフィットすることがあります。
モデルの周辺プラットフォームも重要です。ログ、権限、ソース管理、レビュー手順、データ要件、チームのワークフローは、小さなベンチマーク差を上回ることがあります。
以前からの基準を知りたい読者は、6.1 のアップデートで何が変わるのかを評価する前に、iWeaver の公開記事 Claude Sonnet 5.5 vs GPT-6 comparison を確認できます。
コスト:同じトークン価格でも、タスクのコストは別物
両モデルは、入力トークン 100 万あたり $2、出力トークン 100 万あたり $10 の標準価格を掲載しています。とはいえ、タスクを完了するためのコストが同じという意味ではありません。
総タスクコストには、プロンプトサイズ、キャッシュの挙動、推論の努力量、ツール呼び出し、リトライ、出力の長さ、そして人によるレビューが含まれます。Anthropic は Sonnet 5.5 が Sonnet 5 より少ないトークンで、より速く動かせると言っていますが、それは前モデルとの比較であって、GPT-6.1 Sol より安いことの証明ではありません。
許容できる結果に到達するまでの「総コスト」を測定してください。ある 1 回の回答が長くても、修正回数が少ないモデルのほうが安く済むことがあります。
どのモデルを選ぶべき?
優先度が「範囲が明確なコーディング」「迅速な反復」「ドキュメントやオフィス用途の出力」であるなら、Claude Sonnet 5.5 を試してみてください。その強力な公開エビデンスと製品上の位置づけは、そうしたタスクに合致しています。
大きなコンテキストウィンドウ、OpenAI のツールエコシステム、複雑なマルチステップ作業、あるいは Astra への低コスト代替が必要なら、GPT-6.1 Sol を試してみましょう。また、アプリケーションがすでに Responses API に依存している場合は、より自然な選択肢になります。
公平な判断のためには、1 つの汎用プロンプトではなく、3 つの代表的なタスクを実行してください。日常的なタスク、難しいタスク、ソース量が多いタスクです。正確性、完全性、レイテンシ、総トークン数、不必要な変更、レビュー時間をスコアリングします。
iWeaver で GPT-6.1 Sol を無料トライアル開始 し、自分のドキュメントやリサーチワークフローで評価できます。最適なモデルとは、最小の総工数で品質基準を満たすモデル――一番大きく打ち出された見出しのモデルではありません。