
Claude Sonnet 5.5 と Claude Opus 5.5 は、「優れている/より良い」という単純な階層によって分かれているというより、タスクの形状によって分かれています。Anthropic は、Sonnet を日常的で範囲がきちんと定まった作業向けのより速く、低コストな選択肢として位置づけています。一方 Opus は、複雑で、終わりの定まらない問題に対して、多くのステップにわたる慎重な判断が必要なケースを想定しています。Sonnet は標準の入出力トークンあたりのコストが Opus の半額なのに、公開されたいくつかの評価では Opus に驚くほど近い結果を示しています。
ベンチマークは、管理された状況でモデルが成功したかどうかを示せますが、長いプロジェクトの間に、モデルが曖昧さをどれだけ確実に扱えるか、あるいは競合する制約を見失わずに維持できるかまでは捉えきれないことがあります。2つのモデルの選択は、ルーティングの判断です。タスクの品質要件とリスク要件を満たす、最もコストの低いモデルを使いましょう。
Sonnet 5.5 vs Opus 5.5 を一目で見る
| 詳細 | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| リリース日 | 2026年9月28日 | 2026年9月22日 |
| 標準入力価格 | $2 per 1M tokens | $4 per 1M tokens |
| 標準出力価格 | $10 per 1M tokens | $20 per 1M tokens |
| キャッシュ読み取り価格 | $0.20 per 1M tokens | $0.20 per 1M tokens |
| キャッシュ書き込み価格 | $2.50 per 1M tokens | $5 per 1M tokens |
| 説明されている役割 | 速く、範囲が明確な日常作業 | 持続的な判断を要する複雑な作業 |
| APIモデル名 | claude-sonnet-5-5 |
claude-opus-5-5 |
上記の数値は、Anthropic の Sonnet 5.5 と Opus 5.5 に関する公式発表に基づいています。これらは標準的なAPI料金です。高速モード、地域推論、クラウドプラットフォーム、サブスクリプションの提供形態によっては、別の価格体系や利用ルールが適用される場合があります。
ベンチマークが本当に示していること
Sonnet 5.5 は、Anthropic が報告したいくつかの評価において Opus 5.5 に非常に近いのですが、リード(先行)はタスクによって入れ替わります。だからこそ、2つのモデルを単一のスコアに還元すべきではありません。
| ベンチマーク | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% |
| FrontierCode 1.1 Main | Max のとき 46.2% | 54.4% |
| CursorBench 4.0 | 55.5% | 57.8% |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
公開された Terminal-Bench の結果では Sonnet がリードし、FrontierCode、CursorBench、GDPval-AA、AA-Briefcase では Opus がリードしています。非常に小さな GDPval-AA の差は注目に値しますが、Anthropic は明確に「Opus は、社内の評価だけでなく外部のテスターの経験においても、持続的な判断を要する複雑でオープンエンドな作業に関して、よりはっきり強いままだ」と述べています。ベンチマークの構成や努力設定も異なるため、2点差のような数値ギャップを、完全な能力の判定と見なすべきではありません。
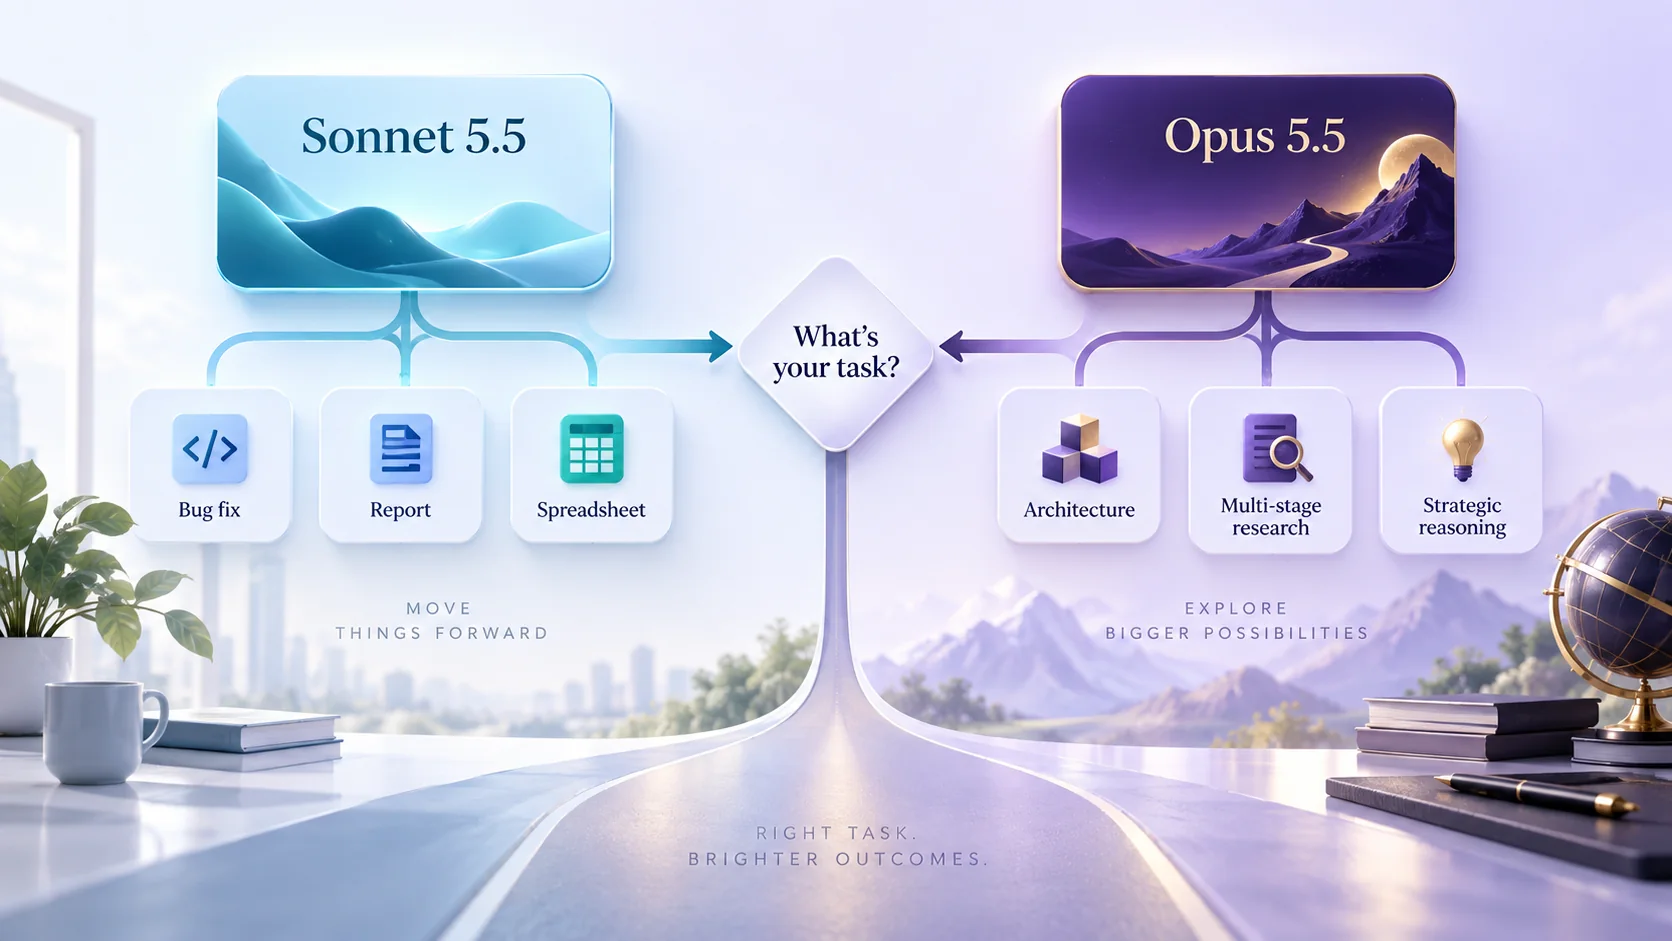
成功を、広範な解釈なしに明確に記述し、チェックできるときに Sonnet は理にかなっています。たとえば、再現可能なバグの修正、既知のデータセットの変換、定義された一連のドキュメントの要約、承認された調査結果からのプレゼン作成、あるいは多数のファイルに一貫した書き換えを適用する、といったケースです。これらのタスクは難しいこともありますが、境界があり、到達すべき終着点が認識できるタイプです。
価格差は、処理量が増えるほど重要になります。標準の入出力トークンのコストは Opus の半額で、キャッシュ読み取りは同額です。Anthropic も、Sonnet 5.5 が Sonnet 5 より出力を30%以上速く生成すると述べています。ただし、この主張は Opus 5.5 との直接的な速度比較として提示されているわけではありません。チームは、環境ごとに「ティア名が応答時間を予測する」と決めつけるのではなく、自分たちの負荷下でレイテンシを測定すべきです。
繰り返しのワークフローでは、Sonnet の調整可能な努力設定がコスト管理に役立ちます。低い努力設定は分類、フォーマット、定型のドラフトに適しているかもしれません。高い努力設定は、より多くのチェックが必要なコード変更や分析に対して正当化される場合があります。重要なのは、すべてに最大の努力を使うことではなく、受け入れテストを設定し、難しいケースはエスカレーションすることです。
Opus 5.5 が高い価格に見合う場面
Opus は、モデルが作業しながら問題を定義し直す必要があるときに、より有力な候補になります。複雑なコード移行、部門横断の戦略設計、多段階の調査、あるいは曖昧な分析では、前提を見直し、制約のバランスを取り、長いアクションの連鎖の中で一貫性を保ち続けることが求められる可能性があります。これらこそ、Anthropic がいう「持続的な判断」によって意味づけられる状況です。
価値の計算もリスクとともに変わります。上級のレビュー担当者が、もっともらしいが微妙に間違った答えを直すのに何時間も費やす必要があるなら、トークン節約は誤った節約だったことになります。Opus の高いレートが、1回の成功で大きな手戻りを回避できるなら十分に価値があるかもしれませんが、それでも明確な基準に照らして評価すべきです。プレミアムというラベルは、ソース確認、テスト、人間の承認の必要性を消し去るものではありません。
コーディング:威信ではなくスコープでルーティング
コーディングでは、まずタスクの境界から始めましょう。Sonnet は、ローカライズされたバグ、明確に仕様が定まったエンドポイント、テスト生成、範囲が限定されたリファクタリングのデフォルトとして強力です。Opus は、アーキテクチャ作業、複数リポジトリにまたがる連携、要件が不完全な移行、あるいは根本原因が分からない調査に対して、より説得力があります。
ルートを正式化する前に、代表的なサンプルで両方のモデルを試してください。正確性、回帰リスク、不必要な編集、テスト品質、経過時間、トークン使用量、そしてレビュー担当者の工数をスコア化しましょう。Anthropic の FrontierCode に関する注記もここで関係します。より多くの推論は、エージェントが要求されたスコープの外側に変更を加えてしまうことにつながり得るため、品質には「いつ止めるべきか」を理解していることも含まれます。
調査・ドキュメント作業
Anthropic の知識労働に関する評価で、Sonnet は Opus に非常に近いスコアを出しています。構造化されたドキュメントのワークフローでは、魅力的な選択肢になり得ます。5つのレポートを比較する、指定された項目を抽出する、承認済みのメモをデックのアウトラインに変換する、といった仕事なら、Sonnet はより低コストで求められる品質を提供できる可能性があります。情報源が食い違うとき、リサーチの問いが進むにつれて変化するとき、あるいはモデルが難しい解釈の選択を行い、それを説明して守る必要があるときは、Opus の魅力が増します。
選んだモデルにかかわらず、ソース準備は出力品質を左右することが多いです。ファイルの重複、バージョンが不明確、文脈の欠落は、強力なモデルでも成果を損ね得ます。iWeaver の AI Summarizer は、混在したファイルやリンクを、上位の分析が始まる前に、要約、重要ポイント、エグゼクティブ・ブリーフ、あるいは構造化されたメモに整理するのに役立ちます。これは補完的な情報整理のワークフローであり、どちらのClaudeモデルが現在 iWeaver 内で選択可能だという意味ではありません。
実用的なルーティングのルール
タスクの入力が明確で、成果物も明確で、検証方法がシンプルな場合は、まず Sonnet を使いましょう。問題が明確化の後も曖昧なまま残る場合、多くの依存する段階にまたがる場合、エラーのコストが高い場合、あるいは Sonnet の受け入れテストに何度も失敗する場合は Opus にエスカレーションします。このアプローチは、すべての依頼に対して1つのモデルを選ぶよりも、通常はコストと品質のバランスが有用になります。
最終的な判断は「完了したタスク」の経済性に基づくべきです。実際の例を通じて、合計トークン数、キャッシュ利用、リトライ、レイテンシ、レビュー時間、失敗の重大度を追跡しましょう。Sonnet 5.5 のベンチマークでの伸びは、信頼できる日常のデフォルトとしての説得力になります。複雑さと判断が「より多く支払う」ことを正当化する場面では、Opus 5.5 は引き続き意図的な選択です。より低コストのモデルを詳しく知りたい場合は Claude Sonnet 5.5: Benchmarks, Pricing, Features & What’s New をご覧ください。または How to Use Claude Sonnet 5.5 を続けてください。