
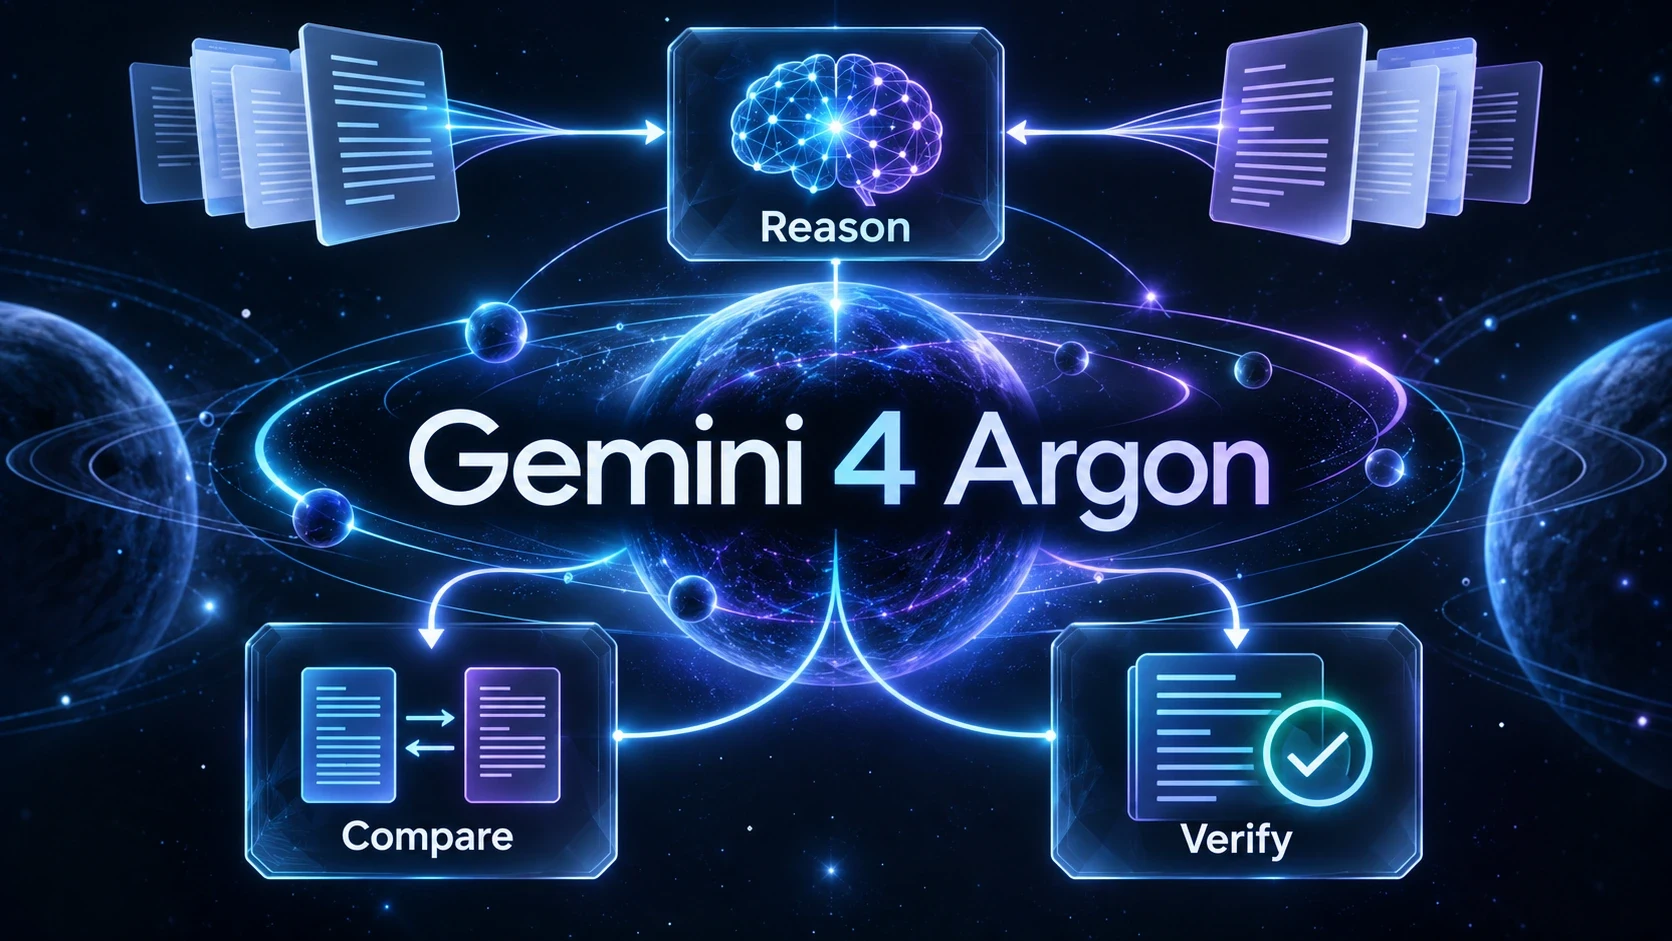
Gemini 4 Argonは、Googleの新しいフラッグシップ推論モデルです。複数ステップにわたって継続的な取り組みが必要な難しい課題を対象としています。たとえば、相反するドキュメントを突き合わせる必要がある方、技術的な問題を調査したい方、あるいは根拠となる情報から主張を組み立てたい方にとって、このローンチは重要です。ポイントは、回答を見直す人による修正が少なくて済む形で、これらのタスクを完了できるかどうかです。
Googleは当初、Argonを信頼できるサイバーセキュリティのパートナー向けに限定したロールアウトで提供しました。Googleは、Geminiアプリにおいて、Google AI ProおよびUltraの加入者がアクセスできると発表しています。モデルが「初期テスターのみが利用可能」とされていた記事には、その条件の明確化が今必要です。
なぜ持続的な推論が重要なのか
Googleは、Argonを複雑なソフトウェアエンジニアリング、科学的な課題解決、そして長期的なプロフェッショナル業務向けに位置づけています。この位置づけから、評価の「狙いどころ」として有用なのは、初期のミスがその後の複数の判断へ波及し得る領域だと考えられます。とはいえ、それは、すべての要約や文章作成のタスクが必ず改善すること、またはモデルがレビューなしで作業できることを示すものではありません。
3つのレポートから組み立てられたリサーチブリーフを想像してみてください。1つは古い定義を使い、別の1つは別の対象集団を扱い、3つ目はその両方を要約するものの、違いの説明はありません。有用な回答は、推薦を行う前に、これらの境界が見えている状態を保つべきです。調査結果をなめらかに混ぜ合わせた文章は、説得力があるように聞こえても、このタスクには失敗します。
これは、推論モデルにとっての実務的なチャンスです。答えへ向かう作業をしながら、問題の構造を保つこと。評価するには、対立している点、裏付けとなる根拠、そして不足している情報を別々の出力として求めてみてください。それなら、単一の洗練された統合結果よりも失敗を見つけやすくなります。
公開された仕様が実際に意味すること
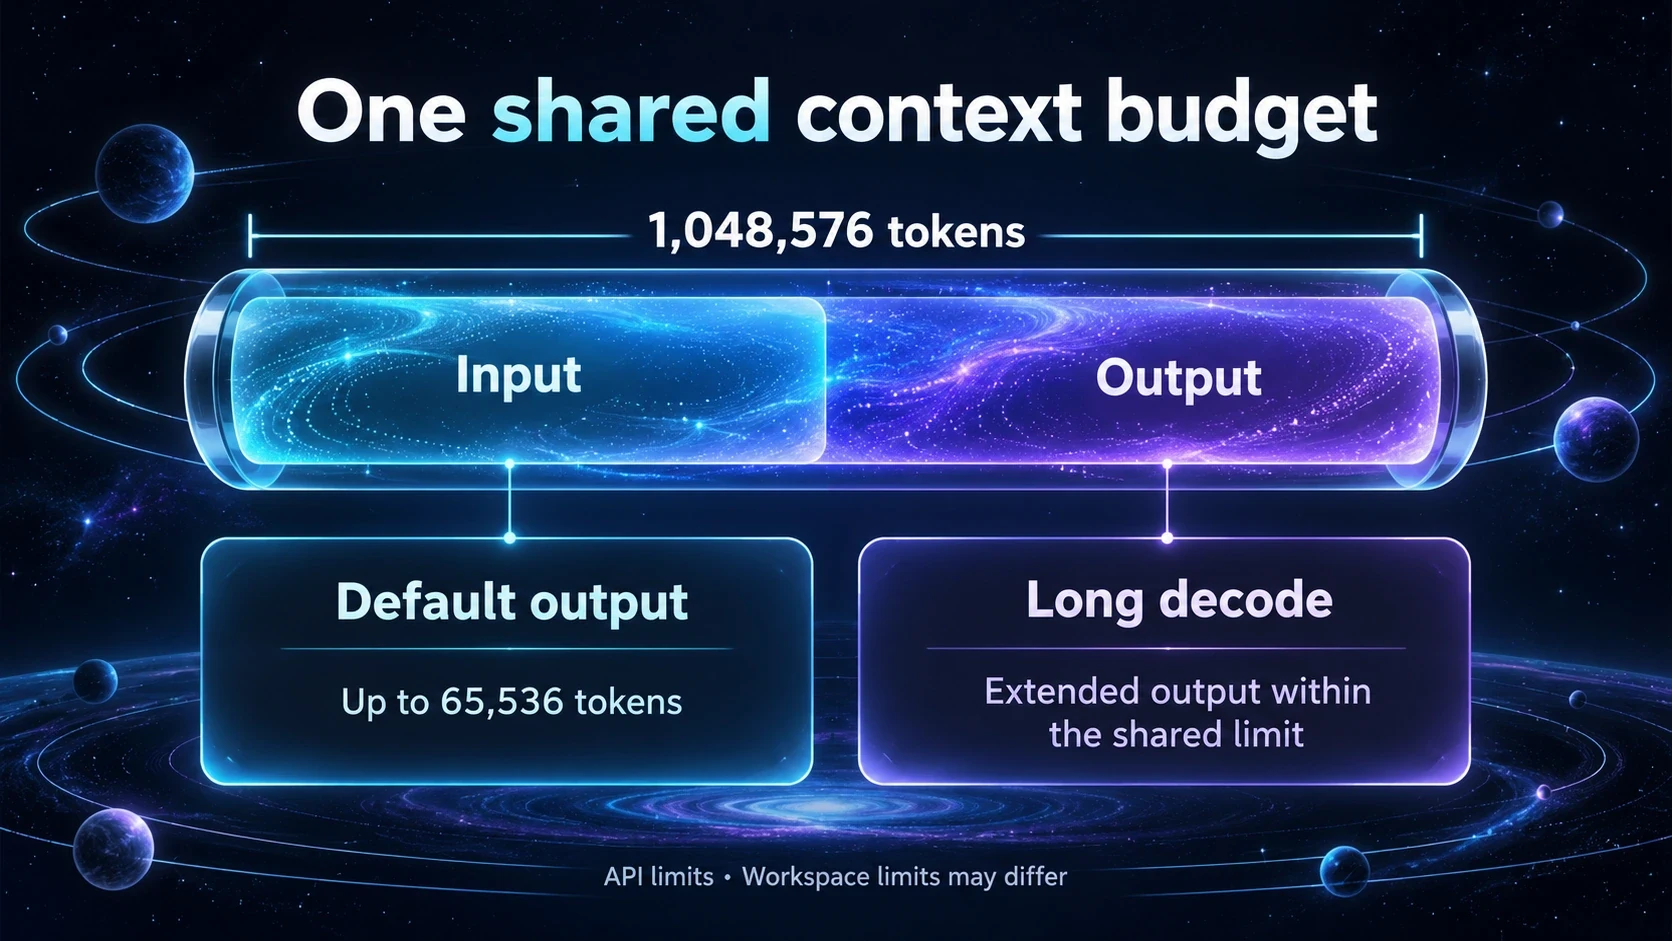
Gemini APIモデルのドキュメントには、テキスト、画像、動画、音声、PDFの入力と、テキスト出力が記載されています。さらに、入力と出力の統合されたコンテキストウィンドウは1,048,576トークンと説明されています。デフォルトの同期出力は最大65,536トークンに制限されています。拡張出力で統合上限まで出力するには、長いデコードが必要です。
これらはAPIの仕様です。アプリやサードパーティーのインターフェースでは、別の能力の組み合わせが提示される可能性があるため、モデルの公開上限を「どの特定のワークスペースでも同様に約束される」とは考えるべきではありません。また、入力のサポートがあることは、画像や音声の生成ができることを意味しません。Argonでサポートされる出力能力として、それらは記載されていません。
ドキュメント作業では、大見出しの数値よりも「容量」と「有用性」の違いがより重要になります。大きなウィンドウは素材を投入する余地をくれますが、どの版が権威ある情報かを決めるわけではありません。出典にラベルを付け、日付を特定し、回答が矛盾にどう対応すべきかを説明してください。短く整理されたソースパケットのほうが、結果を監査しやすくなることがあります。
最初のテストとして使う価値がある3つのタスク
意見が食い違うソースをすり合わせる
特定できるセクションを持つレポートを少数用意します。そして、どの主張が一致し、どれが対立し、定義が違うため比較できないのはどれかを尋ねてください。各発見(finding)に対して出典の参照を要求し、いくつかの参照は自分でも確認します。テストのポイントは、回答が、すでに存在すると分かっている違いをきちんと保持できるかどうかです。
難しい論旨を説明する
内容を十分に理解している一節を選びます。論旨の前提、結論、そして明示されていない前提(暗黙の仮定)を求め、その後、技術に詳しくない読者向けに説明してもらいます。焦点を絞ったドキュメントのワークフローでは、iWeaverのPDF Explainerは、単に短くするだけでなく難解な箇所をほどくために設計されています。
意思決定ブリーフを作成する
2つの選択肢、明確な基準、そしてそれぞれの証拠を提示します。モデルに、どちらを推奨するか、その推奨を変えるであろう証拠は何かを述べるよう依頼し、未回答の質問をフラグ付けしてください。これは、魅力的な表を完成させるために事実を捏造するのではなく、あなたの制約の中で推論できるかをテストすることになります。
既存のGeminiワークフローから切り替えるかどうかを検討しているなら、こちらのGemini 4 Argon vs Gemini 3.8 Flash比較で、タスクの難しさ、出力ニーズ、レビューにかかる手間の比較方法を説明しています。
ローンチのベンチマークの読み方
Googleの発表では、ベンチマーク結果が進歩の証拠として提示されています。有用な手がかりにはなりますが、出所はモデルベンダーであり、評価条件が重要になります。この記事では、Argonがすべてのタスクに最適なベストモデルだと主張したり、独立したハンズオンのベンチマークを報告したりはしていません。
ベンチマークを購入やワークフローの判断に変換する前に、タスク、ツールのセットアップ、そして成功基準を特定してください。次に、それらを自分の業務と照らし合わせます。コードのベンチマークでは、文献レビューの正確性は確立できません。長い回答は、その参照が正しいことを確立できません。
モデルを再現可能なワークフローに組み込む
Gemini 4 Argonは現在iWeaverで利用可能で、iWeaverではモデルの無料トライアルも提供されています。ワークスペースでそれを選択し、受け入れ基準が明確な1つの実際のタスクを使ってください。ソースに基づくワークフローと、適用して変えられるプロンプトについては、Gemini 4 Argonの使い方ガイドをご覧ください。
最初に試す最も強い方法は、検証できるソースに基づくタスクです。証拠を準備し、望ましい出力を定義し、結果を点検し、次回の実行のために修正内容を保持してください。Argonのローンチは、難しい作業の新しい候補をあなたの手元にもたらします。そのワークフローで使い続けるかどうかは、その作業の中で何をうまくこなせるかに依存するべきです。