
GPT-6 Astra、GPT-6.1 Sol、GPT-6 Lunaは、それぞれ異なるレベルの作業向けに設計されています。Astraは、最も難しいエンドツーエンドのタスクに対応する最高性能の選択肢です。GPT-6.1 Solは、複雑な作業のパフォーマンスを保ちながら、価格を大幅に抑えています。Lunaは、集中した高ボリュームの作業に向く経済的な選択です。
多くのプロフェッショナルなワークフローでは、GPT-6.1 Solが最初の選択肢として理にかなっています。Astraの標準的な入力・出力トークン単価の1/5のコストで、OpenAIはAstraに近い性能が得られるとして位置づけています。iWeaverではGPT-6.1 Solの無料トライアルが提供されているので、Astraに上げるかLunaに下げるかを決める前に、実際のタスクでそのバランスを試せます。
GPT-6モデル比較
| 詳細 | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna |
|---|---|---|---|
| 主な役割 | 最も難しいエンドツーエンド作業 | 低コストでの複雑作業 | 集中型の高ボリューム作業 |
| 標準入力価格 | $10 / 1M tokens | $2 / 1M tokens | $0.10 / 1M tokens |
| 標準出力価格 | $50 / 1M tokens | $10 / 1M tokens | $0.50 / 1M tokens |
| コンテキストウィンドウ | 1,050,000 | 1,050,000 | 1,050,000 |
| 最大出力 | 128,000 | 128,000 | 128,000 |
| 推論の手間 | 低〜最大 | 低〜最大 | なし〜最大 |
| 画像入力 | 対応 | 対応 | 対応 |
| 最初に選ぶなら | 最も重要で難しい作業 | 最も複雑なプロ向けワークフロー | 繰り返し作業・コスト重視のタスク |
仕様と位置づけは、OpenAIのモデルカタログ、GPT-6 Astraモデルページ、GPT-6.1 Solモデルページに基づいています。標準のトークン単価には、すべての長いコンテキスト、キャッシュ、処理モード、地域、またはツールに関する料金は含まれていません。
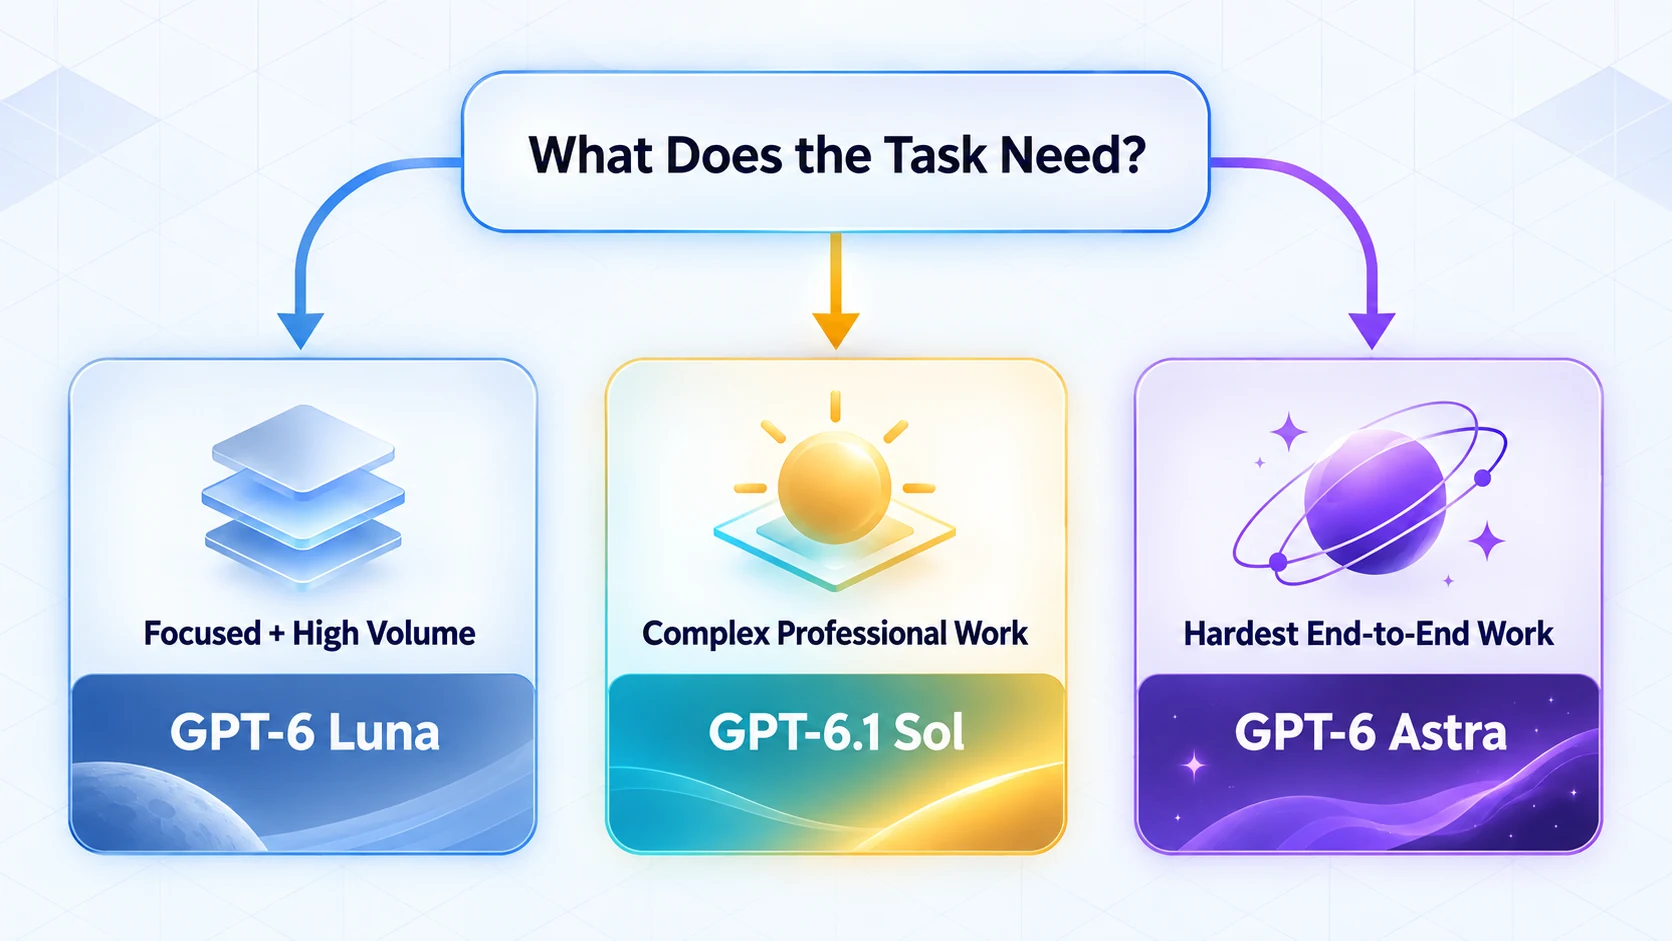
最も難しい作業にはGPT-6 Astraを選ぶ
OpenAIはAstraを、要求の厳しいエンドツーエンド作業における最も能力の高いモデルだと説明しています。これは、難しい推論、ソフトウェアエンジニアリング、リサーチ、コンピュータ利用、そして品質が最安のトークン価格よりも重要になるドキュメント作成などを目的としています。
タスクが曖昧である、複数の段階にまたがる、継続的な判断が必要である、高い失敗コストを伴う、といった場合はAstraが理にかなっています。例として、複雑なシステム移行、オープンエンドの調査、あるいは新しい情報に適応しながら複数のツールを調整する必要があるワークフローなどが挙げられます。
Astraの標準トークン価格はGPT-6.1 Solの5倍です。そのため、すべての定型リクエストをAstraに回すのは無駄になる可能性があります。重要なのは、Astraの追加能力によって、エラーやリトライ、または人の確認が十分に減り、その差を正当化できるかどうかです。
iWeaverの以前のGPT-6 Astra vs Sol vs Lunaガイドでは、家族としての元の比較と、6.1アップデートに向けた有用なベースラインを提供しています。
バランス重視のプロ作業にはGPT-6.1 Solを選ぶ
GPT-6.1 Solは、複雑なコーディング、コンピュータ利用、そしてプロフェッショナルな業務向けに設計されています。Astraと同じように、ドキュメント化されたコンテキストサイズと最大出力サイズを維持しつつ、トークンあたりの料金は大幅に低く設定されています。
そのため、Solはリサーチの統合、ドキュメント量の多い分析、多段階のコーディング、構造化されたレポート作成、そしてエージェントのワークフローなどにおける強力な標準候補です。特に、Lunaでは軽すぎる一方で、毎回Astraを正当化するのが難しい場面で有効です。
GPT-6.1 Solは、low、medium、high、xhigh、maxの推論の手間に対応しています。Mediumがドキュメント上のデフォルトです。まずはそこから始め、代表的な評価で、より難しいタスクがそれによって実際に恩恵を受ける場合のみ手間を増やしてください。
ボリュームと効率にはGPT-6 Lunaを選ぶ
Lunaは、集中した高ボリュームのワークロード向けに、コストを重視したOpenAIのモデルです。標準のAPIトークン価格は、SolとAstraの両方を大きく下回ります。
分類、抽出、変換、短い要約、定型のカスタマー業務、そして明確な指示があるその他の反復タスクに、妥当な候補です。Lunaはnoneの推論の手間に加えて高い設定にも対応しているため、開発者はシンプルなワークロードを速度とコストの両面で最適化する余地がより大きくなります。
低価格だからといって、Lunaが運用上の最安とは限りません。タスクが繰り返し失敗したり、大きな手直し(レビュー)が必要になったりする場合は、Solにルーティングすることで総コストが下がる可能性があります。
実用的なモデル・ルーティングのルール
受け入れ基準を確実に満たす、最も小さなモデルを使いましょう:
- 狭い範囲の反復タスクはLunaから開始する。
- より深い推論、長いコンテキスト、または複数の連携ステップが必要な場合はGPT-6.1 Solへ移行する。
- Solでは必要な品質や信頼性を満たせない、最も難しいタスクにはAstraを確保する。
このルーティング方針は、「どのモデルが勝ちか」を宣言するよりも有用です。モデル選定を、タスクの難易度、リスク、レビューコストに結びつけられます。
差をテストする方法
実際の業務から、小さな評価セットを作成してください。シンプルなタスク、典型的なタスク、難しいタスクの1つずつを含めます。各モデルで、同じ情報源(ソース)、出力要件、スコアリング基準を使用しましょう。
測定項目:
- 正確性と網羅性。
- 指示への準拠。
- サポートされていない主張や不要な変更。
- 時間と総トークン使用量。
- 人によるレビューと修正の手間。
まずはiWeaverのGPT-6.1 Sol無料トライアルを始め、その結果をバランスの取れたベースラインとして使ってください。タスクが簡単に完了するなら、Lunaで十分な場合があります。プロンプト設計と適切な推論の手間を用意したにもかかわらず出力がまだ不足する場合は、Astraは管理されたテストに値します。